如何用 ChatGPT 或 Claude 构建交易算法,检验盈利能力并避免过拟合
一个可复现的 Python 与 Pine Script 交易研究项目:明确规则、实际回测结果、成本、滚动前推检验与蒙特卡洛分析,深入检查过拟合问题。
可以。ChatGPT 或 Claude 能帮助你构建交易算法,最终形成的策略也可能赚钱。在我们实际运行的 Python 研究中,一套固定的比特币突破规则,在 2024 年 1 月 1 日至 2026 年 7 月 31 日期间,扣除模型设定的交易成本后获得了 11.55% 的收益。但它也经历了按日收盘权益衡量的 29.72% 回撤,且收益低于可比的初始配置后买入持有基线。这些是实际完成的历史计算,并非预测,也不能证明某家 AI 服务商拥有交易优势。本文解释用于核查这种区别的规则、计算、交易记账方式和测试。
读完本文,你将得到什么
- 一套定义完整的 55 日突破入场、20 日通道退出策略,及其 Python 记账模型和 Pine Script 差异说明。
- 实际结果,包括亏损交易、手续费、未平仓持仓记账案例,以及与买入持有策略的比较。
- 全部九组开发期参数变体、四个滚动前推评估区间和 15,000 条条件自助采样路径,而不只是挑选出来的漂亮资金曲线。
- 可复用的 ChatGPT、Claude、Codex 与 Claude Code 提示词,以及具体的工作验收条件。
- 明确说明这项研究证明了什么、哪些问题尚未解决,以及前瞻检验应该记录什么。
一个完整的交易研究项目,给出可以核查的答案
“给我做一个能赚钱的交易机器人”实际上把三项工作揉在一起:提出规则、实现规则,以及判断它是否值得投入资本。助手可以生成看起来很有说服力的代码,却没有解决第一项和第三项工作。本文将它们分开:固定一套简单策略,执行有记录的历史研究,并公开结果背后的完整记录。
这个项目是一套按日运行、只做多的比特币突破系统。它的经济假设并不宏大:少数持续趋势,可能足以补偿反复突破失败的成本。令人不舒服的部分恰恰是这一思路的组成部分。趋势跟随策略可能在多数交易中亏损,依赖少量大幅盈利的交易。因此,我们既检查账户最终余额,也检查各笔交易盈亏的分布。
这项研究分别处理策略规则、市场观测、模拟成交和账户结果。我们保留了来源署名、日线输入、15 项可执行测试和完整实验记录。下文解释计算方法,并展示会影响结论的交易与记账案例。
这是一项 AI 辅助工程研究,而不是询问聊天机器人哪种资产会上涨的实验。代码在 Codex 中开发。我们没有把同一任务分别交给 ChatGPT 和 Claude,没有测量它们的投资表现,也没有在策略运行时让语言模型选择交易。代码完成后,算法执行的是确定性规则。
若要集中练习如何核对两套实现,请继续阅读 Python 与 Pine Script 回测:为什么结果不同。
先写清规范,不给看似盈利的歧义留下空间
策略说明应当明确所有可能改变交易清单的细节。“买入 55 日新高”远远不够:上影线触及算不算?当前 K 线是否包含在通道内?已经收盘的日 K 线,难道还能按它此前的开盘价买入?我们的规则要求,完整收盘价超过此前各日最高价,然后等到次日开盘成交。
规则规范和评估流程是在本工作流程计算业绩之前写下的。在此之前,先完成了两项数据修订:更换数据来源,以及处理一条缺失的四小时记录。两项修订均保存在研究记录中。我们没有为了改善结果而修改交易规则。这份记录反映的是内部研究决策的先后顺序,并不是具有独立时间戳的预注册,也不是前瞻实验。
| 组成部分 | 精确规则 |
|---|---|
| 品种与时间基准 | BTC-USDT;每六条四小时记录聚合成一根 UTC 日线 OHLC K 线。 |
| 入场 | 空仓时,已完成的收盘价 > 此前 55 根日 K 线的最高 HIGH;排除当前 K 线。 |
| 退出 | 持有多仓时,已完成的收盘价 < 此前 20 根日 K 线的最低 LOW;排除当前 K 线。 |
| 成交时点 | 收盘时产生信号;在次日原始开盘价上进行不利滑点调整后买入或卖出。 |
| 持仓 | 一个多头持仓,允许小数 BTC,不加杠杆、不做空;退出时卖出全部持仓。 |
| 入场预算 | 可用现金的 90%,包含入场手续费;数量 = 0.9 × 现金 / [成交价 × (1 + 手续费率)]。 |
| 主要成本假设 | 每一侧均收取 10 个基点手续费并施加 5 个基点不利滑点;这些是假设值,不是当前交易场所的报价。 |
| 账户边界 | 每个报告区间均以 10,000 USDT、空仓开始;更早的 K 线仅用于指标预热。 |
| 期末估值 | 按最后一日收盘价估值;不强制平仓,也不预留假设的退出成本。 |
| 未计入的成本 | 税费、固定订阅费、数据费和托管费;不计现金利息、资金费用或借券费用。 |
这里假定的执行边界经过理想化处理。在连续交易的加密货币市场中,当日日线收盘与次日日线开盘紧邻发生;真实系统接收数据、完成计算和提交订单都需要时间。五个基点的滑点只是假设,不能证明在这样的延迟和订单规模下,仍能按该价格成交。
回测开始之前,数据检查就改变了研究范围
输入数据来自 humblefool06 在 Hugging Face 发布的第三方 BTC-USDT 历史存档,发布者声明采用 CC BY 4.0 许可。我们固定了版本 9f491eb5340dd6a24f27fde24edf098e1e785443,保存了发布者的数据集说明卡,并记录 SHA256 哈希。TensorParadigm 将四小时 K 线聚合成 UTC 日线。我们在研究记录中注明了来源署名和转换方法。[1] [9]
覆盖检查发现,2020 年 2 月 19 日缺少 12:00 UTC 的四小时组成记录。我们排除了当天及其之前的全部历史,而没有编造价格。因此,标准化输入从 2020 年 2 月 20 日开始;经过 71 根完整的预热 K 线,开发期从 5 月 1 日开始。保留的全部 2,354 条日线记录均恰好包含六条组成记录。在计算业绩前,我们检查了时间戳顺序、重复项、有限数值和 OHLC 一致性。
哈希可以标识使用了哪些字节,却不能证明发布者的价格正确。我们没有独立地将这份第三方存档与交易所记录核对。更有力的投资研究,应当使用独立取得的数据源重复分析,并调查差异。可复现性与来源准确性相关,但不是同一个要求。
| 区间 | 日期 | 用途 |
|---|---|---|
| 开发期 | 2020 年 5 月 1 日至 2022 年 12 月 31 日;975 天 | 报告固定规则及全部九组预先指定的参数变体。 |
| 验证期 | 2023 年 1 月 1 日至 12 月 31 日;365 天 | 报告未经修改的 55/20 规则;不据此修订主策略参数。 |
| 保留历史评估期 | 2024 年 1 月 1 日至 2026 年 7 月 31 日;943 天 | 固定规则的主要结果,以及自助采样的输入。 |
| 次要滚动前推实验 | 2023、2024、2025 年及 2026 年 1 月至 7 月 | 用较早数据选择参数,再评估下一区间;日期与上述区间重叠。 |
我们将固定规则的最后一段称为“保留历史评估期”。它依然是历史数据,而市场的大体历史已经为人所知。此外,后文的次要滚动前推实验会再次使用部分重叠日期。纵观本文的所有分析,并不存在一个始终未被使用过的最终样本。把它称为独立实盘检验,会夸大研究设计的力度。
在编写交易机器人之前,先让助手消除歧义
ChatGPT 和 Claude 可以帮助把研究任务书转化为代码、解释账本并提出测试。Codex 和 Claude Code 能在代码库中工作、编辑文件和运行命令。产品文档中的工程能力,说明值得把它们用于这套流程,但不能证明哪个产品能写出最赚钱的策略。[3] [4]
把固定规范交给助手,要求它在实现前指出尚未明确的选择。本研究的重要细节包括:严格突破还是包含等号的突破、仅使用此前 K 线的窗口、次日开盘执行、包含手续费的现金预算,以及期末未平仓持仓如何处理。答案即使语气再自信,只要悄然替你编造了其中任何一项,就是有缺陷的实现。
实现附件中的固定策略规范。首先指出任何可能改变信号、成交、仓位规模或报告盈亏的歧义。不要添加筛选条件,也不要优化参数。说明每项输入何时可用。将信号逻辑、执行、记账和报告分开。在运行历史业绩计算之前,先建立用于检验时序和现金对账的合成测试。返回完整代码、假设和实验日志。下面的提示词是一份可复用的研究任务书,不是受控模型对比实验的逐字记录。保留实验日志,记录模型与版本、提供的文件、接受的变更,以及此后每一种策略变体。否则,“一个想法”就可能悄然变成几十次未被记录的尝试,只为找出令人满意的回测。
围绕事件顺序构建 Python 回测
引擎的每日循环有意采用固定顺序:先在今天开盘执行昨天待处理的订单,再按今天收盘价对账户估值,最后计算今天的决策。这样可以避免使用日线收盘价,却在同一根 K 线更早的时点成交。两个通道都排除决策所在的当前 K 线。以下简化片段展示了最容易实现错误的两项计算。
# Called at the completed close, after any pending open fill.
entry_level = max(b.high for b in bars[index-entry_lookback:index])
exit_level = min(b.low for b in bars[index-exit_lookback:index])

if not quantity and bar.close > entry_level:
    pending = {"side": "BUY", "signal_date": bar.date}
elif quantity and bar.close < exit_level:
    pending = {"side": "SELL", "signal_date": bar.date}
# Execute pending only on the NEXT loop iteration, at that bar's open.
入场数量计算将手续费包含在 90% 的预算内。设手续费率为 c、不利调整后的买入成交价为 P,数量就是 0.9 × 现金 / [P × (1 + c)]。如果先用 90% 现金买入,再扣手续费,就会超出规定预算。滑点已经体现在 P 中,不能再扣除其估计现金金额,否则会重复收费。
commission = commission_bps / 10000
slippage = slippage_bps / 10000
fill_price = bar.open * (1 + slippage)  # adverse BUY fill
qty = allocation * cash / (fill_price * (1 + commission))
notional = qty * fill_price
fee = notional * commission
cash -= notional + fee
我们实际运行了 15 项合成测试,覆盖未来数据扰动、排除当前 K 线、严格突破、次日开盘成交、不利滑点、含手续费的仓位计算、已平仓盈亏、未平仓权益、同预算基线、期末未成交信号、预热隔离、无效数据和自助采样计算。这些测试验证的是特定的时序和记账性质,不能证明市场优势。
一条有用的不变量,比漂亮图表更能揭示问题:改变日期 t 之后的价格,不能改变 t 之前的决策或成交。另一条是,在浮点容差内精确对账:初始权益 + 已平仓交易净盈亏 + 未平仓持仓按市价计量的盈亏 = 期末权益。运行程序会为模拟的每个账户检查这一恒等式。
一份明确披露差异的 Pine Script 实现
我们也编写了 Pine Script 实现,在标准日线图上表达相同的此前通道入场与退出思路。它使用已确认 K 线,并安排普通订单在下一根 K 线成交。TradingView 的策略经纪商模拟器及其设置决定模拟成交,图表数据和日内路径假设都可能影响结果。[2]
我们没有在 TradingView 中编译这份配套脚本,也没有取得 Strategy Tester 结果。本文所有业绩数字均来自 Python 引擎。Pine 源码接受了代码层面的审阅,这项检查的范围小于实际运行。
两处实现有意没有保持完全一致。Pine 的滑点设置使用固定跳动点数,而 Python 使用随价格变化的五个基点;我们的 Pine 版本使用零跳动点,因此不能复现主要成本模型。Pine 原生的权益 90% 仓位模式,也不同于我们包含入场手续费的现金 90% 预算。因此,不能声称两者的账户收益等效。
真正比较两个引擎时,应先统一数据源、UTC 边界、预热历史、日期窗口、数量口径和手续费。在比较收益之前,先比较信号日期与成交账本。如果交易不同,最终余额相近只是偶然一致,不能视为验证。
实际结果:样本内盈利,但收益低于持有基线
在 943 天的保留期内,固定算法将 10,000 USDT 变成了 11,154.96 USDT。11.55% 是这一整个区间的累计收益,并非年化。按日收盘权益计算的最大回撤为 29.72%。它完成了八笔平仓交易,其中三笔盈利,期末为空仓。因此,在这个区间,正的净结果不依赖期末未实现的持仓盈亏。
基线在区间第一个开盘时,以初始现金的 90% 为总预算买入,预算包含入场手续费,然后持续持有。其收益为 43.66%,按日收盘计算的回撤为 51.05%。它没有持续再平衡至 90%。策略的每日平均投资敞口为 33.62%;基线则持续持仓,配置比例随价格漂移。更低收益伴随更低回撤是一种取舍,既不能证明阿尔法,也不是风险匹配的比较。
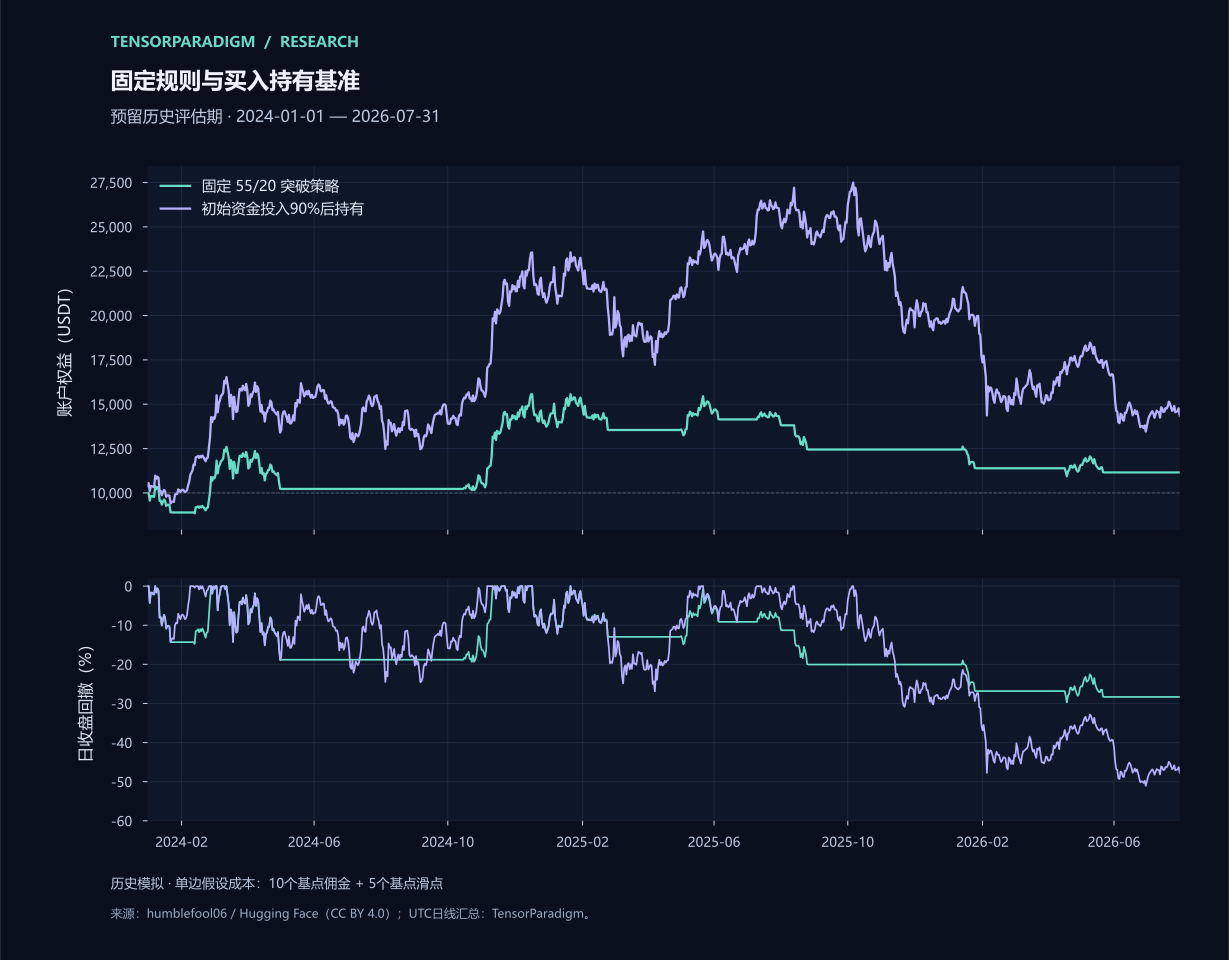
下表每列都是独立、从空仓开始的账户。不能把三个收益率复合成一条连续业绩记录,因为重置方式和期末持仓不同。区间长度也不一样,所以这些百分比不能作为年化收益率直接比较。
| 指标 | 开发期:2020 年 5 月至 2022 年 | 验证期:2023 年 | 保留期:2024 年 1 月至 2026 年 7 月 |
|---|---|---|---|
| 账户净收益率 | +170.39% | +16.55% | +11.55% |
| 期末权益,USDT | 27,039.04 | 11,654.60 | 11,154.96 |
| 按日收盘计算的最大回撤 | 41.48% | 24.27% | 29.72% |
| 已平仓笔数 / 期末未平仓笔数 | 5 / 0 | 4 / 1 | 8 / 0 |
| 已平仓交易胜率 | 60.00% | 25.00% | 37.50% |
| 已平仓交易净利润因子 | 4.05 | 0.66 | 1.28 |
| 每日平均投资敞口 | 41.68% | 57.59% | 33.62% |
| 初始配置 90% 后持有的收益率 | +82.46% | +139.71% | +43.66% |
| 持有基线按日收盘计算的最大回撤 | 75.56% | 18.90% | 51.05% |
2023 年的结果说明,交易摘要为什么可能误导。四笔已平仓交易亏损了 669.03 USDT,账户却盈利 1,654.60 USDT,因为剩余未平仓持仓扣除入场成本后的按市价盈亏为 2,323.63 USDT。我们没有预留假设的退出手续费。已平仓交易利润因子为 0.66,与账户总收益为正,可以同时成立。
相信盈利账户之前,先审计一笔亏损交易
保留期的第一个入场信号出现在 2024 年 1 月 2 日。策略按 1 月 3 日原始开盘价 44,946.91 USDT,加上五个基点的不利调整后,以 44,969.383455 买入。总入场预算为 9,000 USDT,买入数量约为 0.19993623 BTC。入场名义金额为 8,991.008991 USDT,手续费为 8.991009 USDT。
1 月 22 日的退出信号,带来了 1 月 23 日的成交。原始开盘价 39,568.02,经过卖出不利滑点调整后变成 39,548.23599。卖出名义金额为 7,907.125205 USDT,扣除 7.907125 USDT 手续费后,收回 7,899.218080 USDT。减去最初 9,000 USDT 的入场现金成本,净亏损为 1,100.781920 USDT。加上未动用的 1,000 USDT 现金,空仓账户此时持有 8,899.218080 USDT。
| 记录 | 数值 |
|---|---|
| 入场信号 → 成交 | 2024 年 1 月 2 日 → 1 月 3 日 |
| 入场成交价 / BTC 数量 | 44,969.383455 / 0.19993623 |
| 入场名义金额 + 手续费 | 8,991.008991 + 8.991009 = 9,000.000000 USDT |
| 退出信号 → 成交 | 2024 年 1 月 22 日 → 1 月 23 日 |
| 退出名义金额 − 手续费 | 7,907.125205 − 7.907125 = 7,899.218080 USDT |
| 交易净盈亏 | 7,899.218080 − 9,000.000000 = −1,100.781920 USDT |
这份账本比四舍五入后的百分比,更适合检查实现是否正确。它揭示了信号时序、不利成交价、手续费计费基础,以及投入现金的单笔交易收益率(−12.23%)与账户变化(−11.01%)之间的区别。如果助手无法核对这些金额,进一步优化只是在不可靠的计算上增加复杂性。
成本很重要,但这里的利润集中度更值得关注
在保留期主策略运行中,模型实际计提的手续费合计为 171.19 USDT。按数量加权、不利成交价相对原始开盘价的差额为 85.59 USDT。后者是以执行参考价衡量的诊断指标,不利成交价中已经包含了它。买入和卖出名义金额合计为初始资本的 17.12 倍,这说明每一侧看似很小的成本为何会不断累积。
我们以三组成本假设重新运行相同规则。零成本运行收益为 13.99%,主策略为 11.55%,高成本运行则为 9.16%。它们是彼此独立的模拟。成本会改变买入数量,以及之后可再投资的现金,因此期末余额之差,并不简单等于主策略运行中手续费与滑点的合计。
| 手续费 / 不利滑点 | 净收益率 | 按日收盘计算的最大回撤 |
|---|---|---|
| 0 / 0 个基点 | +13.99% | 28.77% |
| 10 / 5 个基点:主要假设 | +11.55% | 29.72% |
| 20 / 10 个基点 | +9.16% | 30.66% |
三笔盈利的已平仓交易赚了 5,244.53 USDT,其余五笔亏损了 4,089.57 USDT,净盈利为 1,154.96 USDT。对少数赢家的依赖,可能符合趋势跟随的特点,但仅有八笔交易,很难证明这些赢家会多可靠地再次出现。减去最好的三笔盈亏,是集中度诊断,并不是一个有效的反事实账户;不能假设跳过这些交易后,之后的仓位规模仍然不变。
这些收益没有扣除固定成本。真实账户还应减去实际归属于这套流程的数据、软件、模型调用和托管费用,再按适用规则考虑税费。确定性的日线规则,不需要每根 K 线都调用一次大语言模型 API。普通代码能够完成的计算,不必额外叠加持续支出。
避免过拟合,要交代整个搜索过程,而不只是欣赏赢家
过拟合往往在正式运行优化器之前就已开始。换个资产、改个起始日期、加一道筛选条件、查看结果并保留漂亮版本,每次选择都会扩大实际搜索范围。传统留出集经过反复查看后,也可能变成开发数据。回测过拟合研究讨论的就是这种筛选问题;它并不会给所有使用训练与测试划分的流程颁发通用合格证。[5]
我们固定了九组开发期配置:入场窗口 40、55、70 天,分别搭配 10、20、30 天的退出窗口。下表列出全部净收益率。无论排名如何,55/20 始终是固定主规则。部分配置生成完全相同的交易,因此九行结果不是九份独立验证。
| 入场窗口 | 10 天退出 | 20 天退出 | 30 天退出 |
|---|---|---|---|
| 40 天 | +140.64% | +164.32% | +123.77% |
| 55 天 | +146.06% | +170.39%:固定主策略 | +161.82% |
| 70 天 | +146.06% | +170.39% | +161.82% |
这九组配置在开发区间均实现盈利。这对理解这一小片参数区域有帮助,但不能证明最优参数,也不能证明在不同资产和市场状态下都稳健。主策略在开发期仅有五笔已平仓交易,尤其不足以支撑参数结论。我们没有估计正式的回测过拟合概率,也没有计算经筛选调整的显著性水平。
在你自己的项目中,保留那些未能进入最终表格的尝试。如果看过后期样本后再修改规则,就应诚实地给修订策略贴上标签:它已经使用了这个样本。换个文件名,不能恢复信息隔离。
审查这份策略规范、实验日志和代码,检查前视偏差、重复使用测试集,以及未记录的筛选。追踪输入可用时间与成交时点。对每个疑似实现缺陷,构造能够使其暴露的最小测试样例。将程序缺陷与建模假设、投资假说分开。不要通过修改参数改善业绩。指出哪些结论缺乏样本支持。滚动前推检验评估的是选择流程,它仍然可能亏损
次要实验提出了另一个问题:如果研究者每年都根据过去数据,从九组变体中选择一组,会怎样?每个评估折的训练期从 2020 年 5 月 1 日开始,止于测试年前一年的 12 月 31 日。选择净收益最高的变体;相同时优先选择回撤较小者,再按入场与退出窗口顺序决定。随后在下一年评估,不在该测试区间内重新调参。按时间划分,可以保持信息流向。[6]
| 测试区间 | 训练结束 | 选中的入场 / 退出窗口 | 测试净收益率 | 测试最大回撤 | 持有收益率 |
|---|---|---|---|---|---|
| 2023 | 2022 年 12 月 31 日 | 55 / 20 | +16.55% | 24.27% | +139.71% |
| 2024 | 2023 年 12 月 31 日 | 55 / 30 | +38.44% | 19.37% | +108.88% |
| 2025 | 2024 年 12 月 31 日 | 55 / 10 | −4.02% | 15.82% | −5.83% |
| 2026 年 1 月至 7 月 | 2025 年 12 月 31 日 | 55 / 30 | −14.24% | 15.35% | −25.52% |
选中的算法在 2025 年亏损 4.02%,在 2026 年 1 月至 7 月亏损 14.24%。选择流程即使严格遵循时间顺序,也仍然可能令人失望。优化过去收益,并不能证明选中的参数将在下一段市场中占优。
每个评估折均以 10,000 USDT、空仓开始。这些是独立重置的测试账户,而不是跨年度持续保留持仓与财富的同一账户。2026 年的区间也并非全年。不能把这些收益率相乘,包装成等同实盘的业绩记录。
2024 至 2026 年的测试日期与主策略的保留历史评估期重叠,后续训练窗口还会包含更早的测试年份。它是明确列出的次要诊断,不是另一份从未使用的留出集,也不是对主要结果的独立复现。
蒙特卡洛分析:准确描述你真正模拟了哪种不确定性
我们采用循环固定长度区块自助法,这是一种用于相依观测的重采样方法。输入是固定主策略运行中的 943 个每日投资组合净收益率,包含空仓日和成本。对 1、10、30 天三种区块长度,分别以随机种子 20261018 生成 5,000 条同为 943 天的路径。区块可以从样本末尾绕回开头;最后一个区块会截取至所需长度。[7]
每条模拟路径对抽到的收益率进行复合计算,并计算自身回撤。这并不模拟新的 BTC 价格,不重新运行突破信号,也不在新顺序下重新计算交易成本。它重排的是已经观察到的投资组合收益。一天区块会丢弃序列顺序,较长区块保留局部连续片段,却不能保留完整历史市场状态。它们都无法添加输入中不存在的危机。
模拟的期末亏损比例介于 39.68% 与 42.66% 之间。这些是此次重采样实验的条件输出,不是策略未来 943 天亏钱概率的估计。对区块长度的敏感性本身就应保留,而不能只选择最令人安心的一列。
| 区块长度 | 期末收益率 P05 / 中位数 / P95 | 最大回撤 中位数 / P95 | 亏损比例 | 回撤 ≥20% 的比例 |
|---|---|---|---|---|
| 1 天 | −44.45% / +11.82% / +126.07% | 34.20% / 56.59% | 39.72% | 94.12% |
| 10 天 | −41.73% / +10.97% / +124.93% | 32.65% / 53.35% | 39.68% | 93.20% |
| 30 天 | −46.51% / +8.87% / +151.72% | 34.38% / 56.34% | 42.66% | 94.60% |
在 5,000 条路径下,亏损比例的蒙特卡洛标准误约为 0.69–0.70 个百分点,计算公式为 √[p(1−p)/5,000]。它衡量的是有限模拟次数带来的噪声,没有包括数据来源、交易规则、未来市场状态,以及重采样假设是否适当的不确定性。运行一百万条路径,只会缩小模拟噪声,不会提供更多市场历史。将蒙特卡洛误差与所研究的不确定性分开报告,是模拟研究的规范做法。[8]
先审计结果,再提出更好的下一步问题
Python 实现使用标准库,根据标准化日线观测进行计算。研究记录保留了分期报告、全部九组开发变体、次要滚动前推结果和自助采样摘要。来源版本与哈希标识了计算使用的观测。
有效的审计可以从保留期期末权益 11,154.96 USDT 和上文的第一笔亏损交易开始。解释最终收益前,先逐项核对信号、成交、手续费和现金变化。我们的计算保留完整精度;文章中经过舍入的表格用于展示,不能替代后续计算的原始输入。
然后判断,你的问题需要什么证据。研究行情源准确性,就获取独立数据集;研究执行,就在现实订单约束下记录决策时间、提交时间、确认回执、成交价和数量;研究修订后的参数选择流程,就在评估另一个时间区间之前写下选择规则。这些是不同实验,在日志中也应分别记录。
比较这些文件中带时间戳的策略信号、已提交订单、已确认成交和核对后的持仓。找出最早出现的分歧。将其归类为数据、时序、仓位、执行或记账问题,并用记录 ID 支持每项发现。不要重新调参。返回对账表,以及能够复现任何程序缺陷的最小样例。如果目标是交易日志或机会扫描器,同样需要这种纪律。在结果发生前,保存规则版本和带时间戳的交易形态;除了实际交易,也保留跳过和拒绝的信号。让助手将日志与执行账本核对,解释差异。事后叙事的价值,低于一份当时就已记录、可以衡量后续结果的决策。
仅使用每次决策之前记录的形态定义和信息。包括已执行、已跳过和已拒绝的信号。将实际交易与订单账本核对。按预先指定的形态类别,报告遵守规则的情况、反复出现的执行错误和结果。将描述性模式与足以支持修改规则的证据分开。标记缺失记录和小样本。我们会把它称为一个盈利交易算法吗?
若仅从狭义的历史记账角度看,会:主策略在保留期账户中,扣除假设的手续费与滑点后,赚得 1,154.96 USDT。但若采用更强的投资含义,即一套已经证明具有可重复优势、值得部署的算法,证据还不够。一个第三方加密货币存档上的八笔已平仓交易,无法证明这一主张。
决策还取决于投资目标。希望累计收益超过持有基线的读者,在主要区间没有得到这一结果。无法承受约 30% 日收盘回撤的读者,会拒绝这条实际观察到的路径。这些是在可能的投资者要求下作出的评价,并不是我们在看到结果前暗中规定的验收门槛。
一个有用的下一步,是冻结规则后开展前瞻模拟盘测试,在信号到来之前记录开始日期,并制定计划,将每项决策与可执行市场情况核对。记录全部修订建议,不要悄悄替换正在测试的版本。模拟执行仍需要现实假设;如果日后选择小规模实盘,它将回答关于真实成交和运营的额外问题。
ChatGPT、Claude、Codex 或 Claude Code 的实际价值,是让个人更快地搭建并核查这套研究体系。研究体系完全可能给出不受欢迎的答案。在本项目中,它给出了历史盈利的账户、显著回撤、低于持有基线的收益,以及少数影响重大的交易。公开这些事实,比让助手为策略写一段更动听的说明更有价值。
在声称交易算法能盈利之前
- 将入场、退出、时序和仓位规则写清楚,使两名独立程序员能够生成相同的交易。
- 保留来源信息、不可变的数据快照或哈希,以及缺失观测记录。
- 证明修改未来数据不会改变更早的决策。
- 核对初始权益加上已平仓和未平仓盈亏,是否等于期末权益。
- 计入不利执行假设、手续费,以及与你的账户相关的运营成本。
- 展示合适的基线,并解释风险敞口和风险水平的差异。
- 保留每一种测试过的配置,包括失败和放弃的尝试。
- 将参数选择与后续评估分开,并披露重复使用的测试期间。
- 将模拟亏损频率理解为以其模型和历史输入为条件的结果。
- 在前瞻测试之前冻结下一个版本;将记录的信号与实际或模拟成交核对。
读者真正需要答案的问题
ChatGPT 或 Claude 能编写盈利交易算法吗?
它们可以帮助实现、测试和调试。我们的固定算法在保留历史期扣除假设的可变交易成本后赚了 11.55%,但收益低于持有基线,回撤达到 29.72%。这支持的是关于本次回测的有限结论,不能证明任一助手都能按要求稳定创造未来利润。
构建交易机器人,ChatGPT、Claude、Codex 和 Claude Code 哪个更好?
本研究没有对它们排名。研究代码在 Codex 中开发,没有运行受控的 ChatGPT 与 Claude 对比。应在相同规范、测试样例和仓库任务下,衡量各工具的重大错误与审查负担。产品编写代码的能力,与策略的投资价值,是两回事。
应该构建 Python 交易机器人,还是 Pine Script 策略?
Pine Script 适合图表检查、策略模拟和提醒。Python 适合自定义数据、记账、参数实验、投资组合和可复现研究。本文的数值结果来自 Python。我们编写并静态检查了 Pine 版本,但没有在 TradingView 中编译或运行它,仓位计算和滑点口径也有所不同。
如何避免交易策略过拟合?
减少主观选择,记录每次尝试,在后续评估之前锁定选择规则,并保持时间顺序。检查邻近参数,用滚动前推区间测试整个选择流程。这些措施可以减少自我误导的机会,但不能保证最终留下的规则具有持久优势。
蒙特卡洛模拟能证明策略会赚钱吗?
不能。我们的循环区块自助法重排已经观察到的每日投资组合净收益率,结果取决于该样本、区块长度和重采样假设。它不会重新生成策略决策,不会发现输入中缺失的危机,也不能估计可靠的现实盈利概率。
为什么盈利回测在实盘中可能亏钱?
历史优势可能消失,小样本可能美化结果,实现也可能使用当时无法获得的信息。价差、延迟、订单规模、部分成交和中断,都可能使真实成交不同。应比较带时间戳的信号、请求订单、确认成交和核对后的持仓,定位差异,而不是立刻重新调参。
这个交易算法需要多少资本?
10,000 USDT 的初始余额只是记账约定,并非最低资金建议。模型允许小数 BTC,忽略交易场所的最小下单量约束和固定运营成本。实际可行性取决于订单限制、流动性、订阅、托管、税费,以及你能够承受的损失。资本变化也会改变固定成本的重要程度。
这个历史 Python 模型会自动交易吗?
这项研究没有开发实盘执行适配器。Python 实现计算的是历史信号、明确假设下的成交与账户结果。实盘系统还需要订单确认、部分成交处理、断线重连、持仓对账,以及重复或过期订单控制。
来源与可复现性
数值结果由 TensorParadigm 根据已注明来源的历史存档自行计算。我们的研究记录保留了生效的研究协议、修订、哈希、标准化数据、程序、测试和完整结果。外部资料支持数据署名、产品能力和方法说明,并不代表它们认可本策略。
- humblefool06 的 BTC-USDT 历史存档:数据集、固定版本与发布者许可声明
- TradingView Pine Script 文档:策略、经纪商模拟器与交易成本
- OpenAI 文档:代码生成与 Codex
- Anthropic 文档:Claude Code 概览
- Bailey 等:《回测过拟合的概率》
- Scikit-learn 文档:按时间顺序划分时间序列
- Politis 和 Romano:《针对平稳数据的循环区块重采样程序》
- Morris、White 和 Crowther:《使用模拟研究评估统计方法》
- 知识共享署名 4.0:署名与改编条款
本研究为教育目的的回顾性研究。收益计入模型设定的可变交易成本,但未计税费和固定运营成本。我们没有开展实盘交易或比较不同 AI 模型投资表现的实验。历史及模拟结果不能证明未来盈利能力。