Pythonで機械学習の売買戦略を先読みバイアスなしでバックテストする方法
実行済みのPython機械学習バックテスト。確定したラベル、毎月の学習、情報時点の検査、実際の取引会計を示し、コスト控除後の損失も報告します。未来の入力を使わない6特徴量。
機械学習の売買戦略をバックテストするには、各判断時点で利用できた情報を再構成します。完成した特徴量、結果が判明済みの学習ラベル、学習データだけで適合した前処理、シグナルより後の約定が必要です。日足ビットコインのロジスティック回帰戦略で、この手順を実行しました。2024~2025年の想定コスト控除後の収益率は−1.67%、初期配分による買い持ち基準は+96.28%でした。一方、未来の収益率を入力する意図的に無効な実装は、+867.06%を稼いだように見えました。収益性を解釈する前に、情報の利用可能時点を検査する必要がある理由です。
本検証で確認したこと
- 時間順に分割しても情報漏洩は起こる。毎月の境界では、学習候補の5行でラベルの結果がまだ確定していなかった。
- 毎月、利用可能な過去の行だけで新しいスケーラーとモデルを適合した。評価期間の先行ラベルも、観測可能になった後でのみ後続の学習に使った。
- 未来の観測値を変えても、正しい実装の過去の予測と注文は一致した。一方、無効な対照実装は検査に失敗した。
- 固定戦略は手数料とスリッページなしで+17.51%だったが、66件の決済取引ではコスト控除後に−1.67%となった。
- 予測指標、損失取引、9種類の開発候補、条件付きブートストラップ経路から、この結果が実資金の投入を正当化しない理由を示す。
まず時刻を置き、その予測が可能だったかを問う
先の先読みバイアス解説では、よくある失敗を説明しました。今回は実際に適合する機械学習パイプラインを構築・実行し、その予測が現金口座にどう反映されるかを追います。問いは具体的です。完成した日足の価格・出来高から作る6特徴量で、単純なモデルがコスト控除後に利益となる5日間のビットコイン取引を選べるでしょうか。
最初に役立つ検査は、具体的な合格例です。2024年1月1日の終値確定時点で、学習に使える最新の特徴量日は2023年12月26日です。その結果は12月27日始値から1月1日始値までなので、すでに判明しています。12月27日の特徴量行には1月2日始値が必要であり、除外しなければなりません。実行した適合には12月26日までの725行が含まれ、1月1日の特徴量行に対する予測は0.452770でした。固定した売買しきい値0.55より低い値です。
再現したという実装が12月31日まで適合していれば、利益を比べる前にラベル終了時点のフィルターを調べてください。確率が違えば、UTC日足の入力、特徴量の順序、スケーラーの統計量、パッケージ版を比較します。魅力的な最終曲線を信頼してもらう代わりに、序盤でデバッグできる基準を示します。完全な実装、プロトコル、出所を示した入力、適合記録、取引台帳はリポジトリの研究記録に保持しています。
収益を測る前に、仮説と口座ルールを固定する
経済的な仮説は控えめです。直近の収益率、ボラティリティ、値幅、相対的な活動量が、次の5日間の始値から始値への動きについて、往復コストの繰り返しを補える情報を含むかもしれない、というものです。ロジスティック回帰なら係数ごとに点検できます。検証に値する仮説ですが、優位性の証拠ではありません。
成績を計算する前に、プロトコルと設定を記録しました。C = 1としきい値0.55は固定し、最良の結果から選んでいません。限定した開発グリッドは後で開示します。開発・評価期間の価格は過去のTensorParadigmプロジェクトですでに扱っているため、未使用の発見サンプルではなく、過去データによる手法の実演です。
| 判断項目 | 固定仕様 |
|---|---|
| 市場と時刻 | BTCUSDT、UTC日足、現物に近い買い保有/未保有の現金口座 |
| 予測 | 終値tの確定時。open[t+6] / open[t+1] − 1 > 0となる確率 |
| 学習 | 毎月、直前730暦日、確定ラベルだけを使用。完全な行が252以上で、両クラスを含む |
| モデル | StandardScaler → LogisticRegression、C = 1、lbfgs、max_iter = 2000 |
| エントリーと決済 | 未保有でp ≥ 0.55なら始値t+1で買い、始値t+6で売る。決済約定日はシグナルを出さない |
| 数量 | エントリー手数料込みで利用可能な現金の90%。BTC端数を許容、1ポジション、レバレッジなし |
| 片道コスト | 手数料10ベーシスポイント、不利な約定調整5ベーシスポイント、スプレッドの追加控除なし |
| 開発 | 2021年、日足365本。2020年の先行観測を初期学習に使用 |
| 検証 | 2022~2023年、730本。年ごとの未保有開始区間も報告 |
| 評価 | 2024~2025年、731本。毎月の再適合手順と設定を固定 |
各期間は10,000 USDT、未保有で始めます。次のモデル予測が違っても、予定した5日後の決済は実行します。最終エントリーシグナルの日は既知のカレンダーから決め、すべての戦略取引を報告期間内に終えます。最後の6日は予測を出せても、新規取引を開始せず、未確定の結果を期間の分類指標に含めません。
データの意味と、未検証の範囲を明らかにする
入力は2020年2月20日から2025年12月31日までの完全な日足2,142本です。humblefool06のBTC-USDT 4時間足アーカイブを、リビジョン9f491eb5340dd6a24f27fde24edf098e1e785443で再利用します。公開者はCC BY 4.0を宣言しています。日足はUTCの6観測から、最初の始値、最大の高値、最小の安値、最後の終値、基軸資産出来高の合計を取って作ります。その前の不完全な日は除外します。正規化CSVのSHA-256は43655a51e6cb41c2ee087bd947f4cefb7dd4151617a29d7f75a3cda471ae5cbbです。[5]
以前の研究で保存した2026年10月18日の照合では、評価期間の全731本、OHLCVの3,655セルが、十進数による比較でBinanceの日足エンドポイントと一致しました。同じ入力とともにその記録を引き継いでおり、本記事のために新しい独立監査はしていません。アーカイブは上流の取引所を明示していません。Binanceとの一致は価格の一致を示しますが、独立した別取引所の検証や、上流データの出所の特定を意味しません。2020~2023年の学習・検証観測は、外部照合が未実施です。Binanceはローソク足を開始日時で識別し、表の日付はUTCのセッションを表します。[6]
プログラムは日付の一意性と昇順、日次間隔の連続性、有限なOHLCV、正の価格、高値・安値の整合する境界を検査します。これは不正な形式を検出しますが、すべての誤観測を見つけるものではありません。また、生き残った暗号資産1銘柄だけでは、当時投資可能だった銘柄群の成績は分かりません。計算に使った版はPython 3.13.3、pandas 2.2.3、NumPy 2.2.6、scikit-learn 1.6.1です。
未来の価格は結果の定義に使い、予測の入力には使わない
6入力は、1日・5日・20日の終値収益率、直近20個の1日収益率の母標準偏差、完成した日の高値と安値の差を終値で割った値、出来高を過去20日平均で割って1を引いた値です。すべての窓は、直前に完成したセッションを含みます。ウォームアップが不十分な行は、後の値で埋めずに除きます。当日の終値は、その確定後の判断には有効ですが、同日の過去の始値での判断には利用できません。
次の特徴量式は、実行したPython実装の抜粋です。過去方向の窓であることが重要です。中心化した窓に変えたり、全履歴で変換を推定したりすれば、判断時点で利用する情報が変わります。scikit-learnの漏洩対策も、変換を学習部分だけから学ぶよう求めています。[1]
returns = close.pct_change(fill_method=None)
X = pd.DataFrame({
    "return_1": returns,
    "return_5": close.pct_change(5, fill_method=None),
    "return_20": close.pct_change(20, fill_method=None),
    "volatility_20": returns.rolling(20).std(ddof=0),
    "range_to_close": (high - low) / close,
    "relative_volume_20": volume / volume.rolling(20).mean() - 1,
})
目的変数は予測する結果を表すため、未来の始値を使います。ラベル1は、生の決済始値が生のエントリー始値を上回ることを示し、等しければクラス0です。手数料控除後に利益が出たという意味ではありません。以下の負のシフトは、目的変数の作成だけに使います。期間末の不明な結果は欠損のままにします。比較演算だけを適用すると、未知の結果を黙って誤ったクラス0観測に変えてしまいます。
target_return = open_price.shift(-6) / open_price.shift(-1) - 1
y = (target_return > 0).where(target_return.notna())
label_end = X.index + pd.Timedelta(days=6)

train_mask = (
    (X.index >= fit_date - pd.Timedelta(days=730))
    & (X.index < fit_date)
    & (label_end <= fit_date)
    & y.notna()
    & X.notna().all(axis=1)
)
学習ラベルが未来まで続くなら、日付分割だけでは足りない
2024年1月1日の終値時点で、単純な過去730日フィルターは2022年1月1日から2023年12月31日までの特徴量日を選びます。このうち5行は使えません。結果が2024年1月2~6日に終わるからです。確定条件で除くと、12月26日までの725観測が残ります。評価記録では、毎月の適合時に同じ5行の除外が生じます。
図は、すでに観測済みの結果と、判断境界をまたぐ結果を区別します。日付は架空の価格経路ではなく、実際のプロトコルです。どちらも文章では1月でも、1月1日の始値は同日の終値時点で利用でき、1月2日の始値は利用できません。
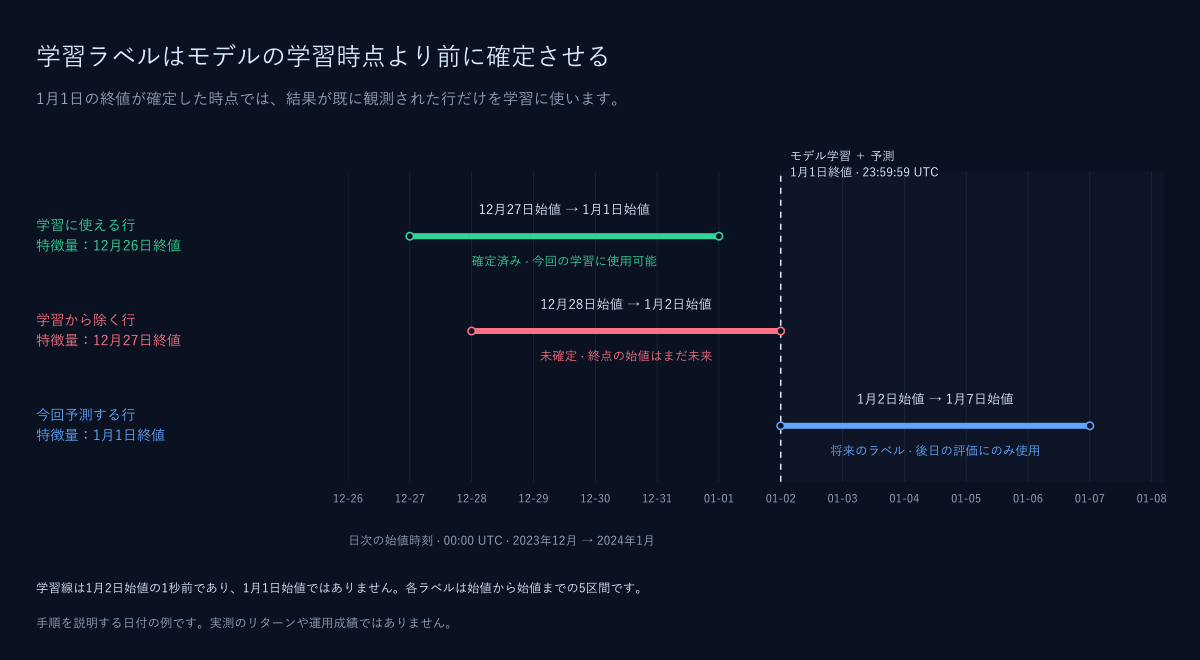
この完全な日次カレンダーでは、最初のテスト特徴量の日付がtのTimeSeriesSplitなら、最後の学習特徴量をt−6にするために5サンプルのgapが必要です。6サンプルなら保守的です。scikit-learnのgapは、経過した暦時間ではなくサンプル数です。保有期間の変動、欠損セッション、遅延データがあれば、この整数をコピーせず、実際の利用可能日時を使う必要があります。記録した適合にはTimeSeriesSplitではなく、明示的なラベル終了時点マスクを使いました。[2]
今回の前向き売買実験では、時間順序を守る必要があります。これは、時系列統計におけるランダム交差検証のあらゆる用途に対する一般論ではありません。ここでは隣接する5日間の結果が重なり、テスト集合より前の行にも未利用可能な目的変数が含まれ得ます。学習境界の漏洩を除いても、残るテスト結果が統計的に独立になるわけではありません。
同じ利用可能な学習窓の中で、スケーラーと分類器を適合する
毎月最初の予測日に新しいパイプラインを作り、結果が確定した過去の行だけで適合し、次の月次適合まで状態を保持します。当日の特徴量行は、その統計量で変換するだけで、スケーラーの適合には追加しません。パイプラインは境界を守る助けになりますが、未来由来の特徴量や、誤って選んだ学習集合を修正はできません。[1]
pipeline = Pipeline([
    ("scale", StandardScaler()),
    ("model", LogisticRegression(
        C=1, solver="lbfgs", max_iter=2000, random_state=6142026
    )),
])
pipeline.fit(X.loc[train_mask], y.loc[train_mask].astype(int))
assert pipeline.named_steps["model"].classes_.tolist() == [0, 1]
p_up = pipeline.predict_proba(X.loc[[signal_date]])[0, 1]
Cは正則化の強さの逆数で、小さいほど強い正則化です。正の確率の列はclasses_ = [0, 1]と照合します。特徴量の順序、学習行のハッシュ、スケーラーの平均と尺度、係数、切片、最適化の反復回数を記録します。ソルバーはlbfgsであり、random_stateを渡したことは決定性の説明になりません。[3]
毎月の再適合では、評価期間内の先行結果も確定後に正当に使います。たとえば2月の適合は、利用可能な1月観測から学べます。これは2年間固定した単一モデルではなく、事前に固定した更新手順を時間の先へ評価するものです。後の評価結果を見て、C、しきい値、特徴量、再適合日程を変えていません。これらを再調整するには、新しい評価プロトコルが必要です。
predict_probaを信頼する前に、最初の採用予測を再構成する
評価期間で最初に採用されたシグナルは、2024年1月12日終値に生じます。まだ1月1日の適合を使い、2022年1月1日から2023年12月26日までの725行が対象です。最後の学習結果は1月1日始値で終わります。表は実際の特徴量ベクトル、学習統計で標準化した値、適合係数を示します。表示は丸めていますが、監査は完全な精度で行います。
| 特徴量 | 生の値 | 標準化z | 係数 |
|---|---|---|---|
| return_1 | −0.076748 | −2.672794 | −0.103549 |
| return_5 | −0.026094 | −0.417899 | −0.111867 |
| return_20 | −0.021039 | −0.200837 | +0.039253 |
| volatility_20 | 0.030521 | 0.420563 | +0.026111 |
| range_to_close | 0.117233 | 2.754973 | −0.019805 |
| relative_volume_20 | 0.778955 | 1.552860 | +0.037502 |
各特徴量についてz = (x − 学習平均) / 学習尺度です。切片0.014133035にzと係数の積の合計を加えると、ロジット0.344416426になります。1 / (1 + exp(−ロジット))を適用すると0.585262925です。0.55を超えるため、未保有の口座は1月13日始値で買う注文を出します。これはモデル上の生の値上がり確率であり、売買純利益の較正済み確率ではありません。
評価初日の確率0.452769888は、正しく取引を発生させません。この2つの監査点で、特徴量や適合の違いと、注文処理の違いを切り分けやすくなります。予測が正しくても、約定、現金による数量決定、決済時刻が誤っていれば、不正なバックテストになり得ます。
予測、注文、現金口座を分離する
条件を満たす終値シグナルは翌足始値での買いと、その5日後の始値での決済を予定します。シミュレーションは実際の約定時に現金を配分し、数量 = 0.90 × 現金 / (買い約定価格 × 1.001)とします。これはブローカー側の現金配分であり、前日に未知だった翌日始値を使って計算した数量ではありません。買い約定価格は生の始値 × 1.0005、売り約定価格は生の始値 × 0.9995です。各手数料はスリッページ反映後の代金の0.001倍です。
if flat and not exited_today and p_up >= 0.55:
    entry_date = signal_date + pd.Timedelta(days=1)
    exit_date = signal_date + pd.Timedelta(days=6)
    if exit_date <= evaluation_end:  # known calendar, not future prices
        pending_buy = (entry_date, exit_date)

# At the entry open:
fill = open_price * 1.0005
quantity = 0.90 * cash / (fill * 1.001)
毎日の終値時点で、純資産は現金とBTC数量 × 生の終値の合計です。ドローダウンは初期残高を含む日次終値口座の、それまでの最高値から測ります。スリッページは価格に織り込まれており、再び引きません。戦略の全ポジションは報告期間内に終わります。一方、買い持ちは最終終値でもBTCを保有し、エントリー手数料を含め、架空の決済手数料は加えません。
暗号資産の日次終値と次の始値は隣接します。その次の始値ぴったりの約定は理想化した仮定であり、モデル計算、取引所、通信の遅延が達成可能かは本研究では分かりません。5ベーシスポイントは感応度の仮定で、板で観測した測定値ではありません。レバレッジ、空売り、ストップ、資金調達料、現金利息、税金、固定運営費、USDT換算を除外し、端数数量は取引所フィルターを無視します。これらがシミュレーションの範囲です。
固定モデルはコスト控除後に損失となり、単純な買い持ちに届かない
コスト控除前の成績は、手数料もスリッページもゼロの別口座で計算します。純成績は、片道ごとに固定した10と5ベーシスポイントの仮定を使います。開発・検証・評価の各口座は10,000 USDTから始まります。表は適合した期待値ではなく、実測結果です。
| 期間 | コスト控除前ML収益率 | 純ML収益率 | ML最大ドローダウン | 決済取引数 | 純買い持ち収益率 |
|---|---|---|---|---|---|
| 開発2021年 | +26.88% | +10.56% | 41.81% | 51 | +53.60% |
| 検証2022~2023年 | −40.06% | −46.76% | 54.13% | 44 | −7.78% |
| 評価2024~2025年 | +17.51% | −1.67% | 27.82% | 66 | +96.28% |
評価期間の機械学習口座は、BTC未保有、決済取引損益−167.49 USDTで終わり、最終残高は9,832.51 USDTです。日次終値の最大ドローダウン27.82%は、平均投資比率が40.63%にすぎないにもかかわらず、買い持ちの30.86%よりわずかに小さいだけです。731回の終値のうち330回でBTCを保有します。エクスポージャーが低いだけで、魅力的なリスク調整後の代替案になるとは限りません。
2つの判断方針の基準は、同じ5日保有、休止、数量、コストのルールを使います。完成した20日収益率が正なら買う方針は、71取引で−11.63%、ドローダウン33.99%です。毎月の確定済み学習ラベルの正例率が0.55に達すれば売買する方針は、36取引で−26.56%、ドローダウン37.85%です。機械学習ルールは今回はこの2方針を上回りますが、損失となり、買い持ちには大きく届きません。特徴量が持続的な経済的優位性を加える証拠としては不十分です。
図の口座は実際に計算した日次純資産です。買い持ちは各期間最初の始値で、同じエントリーコストを使って90%を投資し、10%を現金に残します。市場へのエクスポージャーの大きさも比較の一部であり、機械学習の因果的な寄与を統制して推定したものではありません。広い解釈については、機械学習とルールベース売買の検証をご覧ください。
予測の正確さと取引の収益性は、別の測定である
結果を完全に観測できる評価予測725件を採点します。すでにBTCを保有している間の予測も含みます。残る6件の結果は期間外に延びるため除外します。正のラベルは390件、53.79%です。頻度基準は6特徴量を使わず、各月の確定した学習ラベルの正例率を予測します。
正解率の分類境界は0.50、注文は0.55を使います。Brierスコアは確率誤差の二乗、対数損失は確率誤差への対数的なペナルティ、ROC AUCは順位づけを測ります。数量決定や手数料は含みません。Brierスコアが低いだけで較正が良いとも言えません。較正以外も反映するためです。今回の確率は別途較正していません。[4]
| 評価予測 | 0.50での正解率 | Brier ↓ | 対数損失 ↓ | ROC AUC |
|---|---|---|---|---|
| 6特徴量ロジスティック回帰 | 50.76% | 0.251416 | 0.695919 | 0.502044 |
| 確定した学習ラベルの頻度基準 | 53.79% | 0.249933 | 0.693033 | 0.476881 |
機械学習モデルは、頻度基準のBrierスコアも対数損失も改善しません。AUCの0.5020は0.5に近いですが、重なり合う結果に対して独立観測を仮定した有意性は主張しません。また725予測は725件の独立取引ではなく、実際の決済は66件です。小さな評価指標の差は、経済的な結果を覆す説得的な予測力の根拠にはなりません。
最初の損失取引を、両側の約定と現金残高まで追う
1月12日の予測0.585262925が最初の取引を発生させます。1月13日の生のエントリー始値は42,782.74 USDTです。5ベーシスポイントの不利な執行後、買い約定価格は42,804.131370になります。数量は0.210050027959 BTCです。エントリー代金は8,991.008991 USDT、手数料は8.991009で、現金はちょうど1,000 USDT残ります。
必須の1月18日決済は、生の始値42,776.09、売り約定価格42,754.701955を使います。手数料は8.980626 USDTです。スリッページ反映後の約定間の価格損益は−10.382650、両手数料を引くと−28.354285 USDTです。最終現金は9,971.645715です。初期10,000と未保有の最終状態に照合でき、モデルの確率は予定決済を変更しませんでした。
評価期間の66取引のうち、コスト控除後の利益は32件、損失は34件で、勝率48.48%です。平均利益は+332.83 USDT、平均損失は−318.18で、損益比は約1.05です。平均取引は−2.54 USDT、プロフィットファクターは0.9845です。勝率や生の方向予測だけでは現金結果を説明できません。手数料、約定価格、変動する資金、損益の大きさが影響します。
高収益に見えても、情報漏洩するモデルを検査で失敗させる
2024年6月15日より後の全観測を変更し、OHLC価格を2倍、出来高を3倍にしました。それ以前の値は固定しました。正しいモデルを再構築しても、過去の特徴量、利用可能な学習行列、スケーラー・モデル状態、予測、判断、約定は変わりませんでした。過去の確率差の最大値は厳密にゼロです。これは本実装で実行した不変性検査であり、あらゆるバイアスを取り除いた証明ではありません。
changed = bars.copy()
future = changed.index > cutoff
changed.loc[future, ["open", "high", "low", "close"]] *= 2
changed.loc[future, "volume"] *= 3
# Valid: past features, fit states, predictions and orders are identical.
# INVALID control: X also contains target_return, so this check fails.
負の対照実装は、実現した未来の始値間収益率を7番目の入力として意図的に加えます。同じ月次パイプラインと口座ルールを保ちますが、予測時の情報利用可能性に違反します。見かけの純収益率+867.06%、分類正解率97.66%、AUC 0.998676を報告します。これは無効(INVALID)なバックテストの測定であり、戦略候補でも選択に使った結果でもありません。
同じ未来の改変によって、無効なモデルの過去の確率は最大0.998626629変わります。正しいスケーラー、時間順の適合、もっともらしい注文会計でも、利用できない入力は救えないと示す対照です。一方、境界にある5つの未確定ラベルは目立ちにくい誤りです。派手な成績変化がなくても、カレンダーから無効と分かります。
研究のテストは、過去方向の特徴量時点、期間末の欠損ラベル、ラベル確定の正確な境界、学習データだけの標準化、月次適合の再利用、分類対象期間の境界、重複しない注文、決済日の休止、手数料込み数量、現金・損益照合、決定的なブロック再標本化も対象にします。情報順序の検査は、既知の壊れた実装で失敗すべきです。コードが動くと観測するだけでは、弱い証拠にすぎません。
開発グリッドを開示し、不利な検証区間も残す
開発候補はCを{0.1, 1, 10}、エントリーしきい値を{0.50, 0.55, 0.60}とする9組だけです。表は2021年の純収益率を示します。しきい値を変えると魅力が薄れる候補も含め、すべて残します。他の開発設定が良く見えても、事前宣言したC = 1、しきい値 = 0.55を本記事の戦略として維持します。
| C | しきい値0.50 | しきい値0.55 | しきい値0.60 |
|---|---|---|---|
| 0.1 | +7.81% | +10.56% | +25.24% |
| 1 | +7.81% | +10.56% | +55.01% |
| 10 | +7.81% | +10.56% | +55.01% |
しきい値0.50と0.55では、3種類のCすべてが同じ実行取引経路を作ります。確率が同一という意味ではありません。0.60ではC = 0.1の経路が異なります。しきい値の変更は売買条件とその後の休止機会を変えるため、小さな予測差でも複利結果が変わり得ます。このグリッドは、異なる市場期間を通じて安定して利益となる領域を特定していません。
検証は、固定手順と毎月のローリング適合を使います。独立した年次口座は2022年に37取引で−44.04%、2023年に7取引で−4.87%となります。最大ドローダウンは54.13%と8.60%です。それぞれの暦年末除外を持つ未保有開始区間なので、収益率を複利でつないでも、連続した2022~2023年口座と厳密には一致しません。連続評価口座の年次収益率は2024年−1.14%、2025年−0.54%です。
過去の最良候補を選ぶのは、1つの固定ルールを評価するのとは別の研究手順です。Baileyらは、バックテスト間の選択が過剰適合につながる仕組みを形式化しています。小さなグリッドと不利な区間を開示しますが、9設定から正式なバックテスト過剰適合確率を推定したとは主張しません。本報告後に設定を変えれば、これらの期間は開発の証拠になります。[7]
回転売買が総利益を消費し、少数の取引が大きく寄与する
評価口座の約定は132回です。買いと売りの代金の合計は初期純資産の122.29倍です。この片道回転率の定義は両側を含み、口座全体を122回転させたという意味ではありません。手数料は計1,222.92 USDTです。生の始値に対し、価格に含まれた執行不利分は計611.46 USDTです。コストを変えると後の数量も変わるため、この台帳合計を別のコストゼロ口座から引いても、純結果を厳密には再構成できません。
感応度表は、片道手数料10ベーシスポイントとモデルの判断を維持し、不利なスリッページだけを変えます。スリッページゼロでも+4.34%にすぎず、10ベーシスポイントなら−7.34%です。したがって、十分な執行上の余裕を示す研究ではありません。手数料・スリッページなしの+17.51%は会計の理解には役立ちますが、達成可能な純収益予測ではありません。
| 片道手数料 | 片道スリッページ | 評価純収益率 | 最大ドローダウン |
|---|---|---|---|
| 10 bp | 0 bp | +4.34% | 27.37% |
| 10 bp | 5 bp | −1.67% | 27.82% |
| 10 bp | 10 bp | −7.34% | 28.27% |
| 10 bp | 20 bp | −17.72% | 30.67% |
純利益が最大の3取引は+2,764.12 USDTをもたらします。他の全決済取引の合計は−2,931.61です。観測した台帳による記述的な集中度計算であり、その取引を消して後続の現金を変えた再実行ではありません。改善案は、事前に利用できる情報でどう利益を維持するか、回転率を下げるかを説明すべきです。過去の損失取引を削除するだけなら、新たに偏った結果を作るだけです。
新たな証拠を作ったかのように扱わず、口座経路を再標本化する
未保有日も含む日次口座純収益率を、連続20日の円形ブロックで抽出し、各経路が731日になるまでつないで、5,000本の条件付き経路を生成しました。シード6142026で計算を固定します。サンプル末尾から先頭に戻り、連続ブロックを保つことで局所的な依存の一部を保持します。Politis・Whiteの円形再標本化の構成を使いますが、ブロック長は20日固定で、自動選択法は使っていません。この選択は、関連する依存をすべて捉えることも、収益過程の定常性も保証しません。[8]
最終収益率の5パーセンタイル、中央値、95パーセンタイルは−42.11%、−1.03%、+61.61%です。最大ドローダウンでは16.79%、30.26%、51.19%です。再標本化した経路の51.44%が初期純資産を下回ります。この割合は過去サンプルと再標本化ルールを条件とする値であり、現実でこの戦略が損失となる確率の推定ではありません。
このブートストラップは、実現した口座収益率系列を並べ替えます。価格を再生成せず、モデルを再適合せず、注文を再計算しないため、抽出した系列が実行可能な売買履歴とは限りません。起きたことを条件とする経路感応度を調べるものです。経路数を増やせばシミュレーション誤差は減りますが、新たな市場観測、独立取引、予測上の優位性の証拠は加わりません。
AIの共同作業者に、実際に検査できる合格条件を渡す
ChatGPTやClaudeは、売買アイデアを正確な仕様にし、曖昧さを問い直す支援ができます。CodexやClaude Codeは、リポジトリファイルを扱い、計算を実行し、失敗を調べられます。公式製品文書はこれらの開発用途を裏づけますが、売買の優位性を示しません。本プロジェクトはCodexの支援とローカルPython計算を使いました。統制したChatGPT対Claudeの比較、LLMによる市場予測、独立した専門家の査読は行っていません。[9] [10]
以下のプロンプトは、4つの異なる仕事を検証可能にします。各依頼に固定済み仕様と関連コードを添えます。市場データが観測を供給し、実行可能なプログラムが計算し、仮定と証拠から新たな検証に進むべきかを研究者が判断します。自信に満ちた説明で、照合済み台帳を代用はできません。広い開発手順は、売買アルゴリズムの構築と検証をご覧ください。
UTC日足のBTCUSDTを使い、買い保有/未保有の機械学習実験を仕様化してください。完成した終値tでopen[t+6]/open[t+1]-1の符号を予測します。各特徴量の利用可能時点、目的変数の確定時点、月次学習窓、エントリー・決済日程、現金による数量決定、コストを定義してください。再適合とハイパーパラメーター選択を分けてください。曖昧さを列挙し、2024-01-01終値で使える最新の学習特徴量日を示してください。成績を計算したり、収益率から設定を選んだりしないでください。添付の固定仕様を、特徴量・ラベル、月次適合、現金口座の別関数で実装してください。StandardScalerはラベル確定済みの学習範囲内だけで適合します。期間末の欠損ラベルを保ち、利用可能日、特徴量順序、スケーラー状態、係数、確率、判断、約定を記録してください。C=1やしきい値=0.55を再調整しないでください。未来のOHLCV変更でも過去の正しい予測・注文がすべて不変のテストを追加し、意図的なtarget_return特徴量では失敗することを示してください。戦略を変えずに2024-01-12のシグナルを監査してください。2024-01-01の適合から、標準化特徴量、ロジット、確率を再構成します。手数料10ベーシスポイント、不利な約定5ベーシスポイントで、1月13日の買いと1月18日の決済を追ってください。数量、現金、両手数料、純損益を示し、初期現金に決済済み・未決済時価評価損益を加えた値と最終純資産を照合してください。最終収益率だけを説明せず、最初に異なる記録を特定してください。記録した出力から研究報告書を作ってください。全開発候補、時間順の期間、総収益と純収益、基準、予測指標、ドローダウン、エクスポージャー、回転率、取引損益の非対称性、コスト、集中度を含めてください。重複ラベルと条件付きブロック・ブートストラップの限界を説明します。未来特徴量の対照は、掲載するすべての場所で無効(INVALID)と表示してください。実行済み計算、説明用抜粋、未実行部分を区別し、過去価格への既知性とデータ照合の限界を開示してください。利益が出る見出しを得るために最適化しないでください。このローリングscikit-learnパイプラインに一致するPine実装は、提供も実行もしていません。ある1か月の係数をコピーすれば、別の固定戦略になります。忠実な比較には、学習窓、標準化、ラベル確定時点、再適合、執行の意味を再現する必要があります。これは研究範囲の限界であり、Pineが機械学習計算を表現できないという主張ではありません。PythonとPineのバックテスト研究では、シグナル式の一致だけでは不十分な理由を説明しています。
正当化できる次の段階は、運用開始ではなく記録した前向き検証
実装は検査した情報順序の性質を満たしますが、固定戦略はコスト控除後に損失となり、主要な確率指標を改善せず、検証期間には深いドローダウンを経験しました。実資金の投入を正当化する結果ではありません。本記事の価値は、妥当な過去測定と、利益が出て見える情報漏洩を区別する方法にあります。
研究を続けるなら、新しい前向きペーパートレード期間を開始前に記録します。特徴量、確定ルール、再適合日程、コスト、報告基準を固定します。完成入力、適合状態、シグナル、実行可能な次の執行に日時を付け、実際の遅延と提示スプレッドを測ります。学習頻度予測と単純な買い持ち口座の両方に比較します。提案した全候補を残し、後続データは結果が確定してから評価に割り当てます。
コストが結果を大きく変えたため、回転率を下げる設計は妥当な新仮説です。ただし、独自の後続検証が必要です。2024~2025年を再利用して別のしきい値や保有期間を選べば、その日付は開発データになります。1市場だけであること、先行データの外部未照合、依存する結果、理想化約定、ライブ執行なしという限界があります。先読み検査の合格はバックテストの解釈に必要ですが、収益性には別の証拠が必要です。
機械学習売買バックテストの確認リスト
- 実際の予測1件について、観測、学習、判断、約定の正確な日時を特定する。
- すべての学習目的変数が適合前に確定していたことを示す。特徴量の日付順だけに頼らない。
- 利用可能な学習行だけで変換を適合し、特徴量の順序と各月のモデル状態を保存する。
- 期間末の未確定ラベルは欠損のまま保ち、予測評価と実行された取引を区別する。
- 未来の改変で過去の出力が変わらないことと、既知の漏洩を入れた対照実装が失敗することを確かめる。
- 価格に織り込んだスリッページや未決済の時価評価を含め、約定コストと現金を照合する。
- 試した全設定、不利な期間、適切な基準、現実的なコストへの感応度を報告する。
- 次の前向き検証は、判断材料となる証拠を観測する前に手順を固定する。
機械学習バックテストの実務的な疑問
時間順の学習・テスト分割で先読みバイアスを防げますか?
未来から過去への混入の一部は防げますが、それだけでは不十分です。境界より前の学習行でも、結果が境界後に確定することがあります。今回の5日間の目的変数では、各適合時に未確定の5行を除く必要があります。前処理、特徴量の利用可能時点、発注・約定の時点にも別々の検査が必要です。
すべての特徴量を1日ずらすべきですか?
いいえ。必要なシフトは時点によって決まります。当日の完成した終値と総出来高は、その終値より後にシグナルを出し、後で約定するために使えます。同日の、それより前の始値での注文には使えません。全入力を機械的にずらすと、他の漏洩を解決しないまま意図した戦略を変えることがあります。
評価期間の観測を、後の月の学習に入れてよいですか?
更新手順を事前に固定し、その適合までに観測の目的変数が確定していれば可能です。新しく利用可能になった履歴から運用中のモデルが学ぶ状況を再現します。評価結果を見てハイパーパラメーターを変えるのは別の選択であり、新しい評価証拠が必要です。
予測確率が0.55を超えれば、取引の期待利益はプラスですか?
いいえ。今回のラベルは、5日間の始値から始値への生の収益率が正かを表します。純期待値は利益と損失の大きさ、コスト、資金、執行にも依存します。モデルの確率は別途較正しておらず、正しい戦略は想定コスト控除後に損失となりました。
売買ラベルのTimeSeriesSplitには、どの程度のgapが必要ですか?
実際にラベルが利用可能になる時点から導いてください。今回の欠損のない日次データで終値tに判断する場合、最新の学習特徴量はt−6です。これは最初のテスト特徴量tより前に5行のgapを置くことに相当します。目的変数、営業日カレンダー、公表遅延が変われば、別のgapや明示的な日時フィルターが必要になります。
ChatGPTやClaudeで機械学習売買ボットの収益性を検証できますか?
実験の仕様化、コード検査、記録された出力の説明を支援できます。収益性は、時点を正しくそろえた観測に対する実行可能な計算と、その後の現実的な条件下の証拠から確かめる必要があります。本研究はCodexの支援を使い、固定戦略に不利な結果を得ました。AI間の投資能力比較やライブ取引は検証していません。
参考資料と研究記録
収益率、モデル出力、口座の例は、TensorParadigmが実行した計算です。リポジトリの研究記録には、成績計算前のプロトコル、設定、出所を示した正規化データ、実行可能なPython実装、テスト、全モデルの適合状態、完全な台帳を保持しています。以下の一次資料は手法、データ、ツールの説明を裏づけますが、戦略を推奨するものではありません。scikit-learnは、計算に使った1.6.1環境に対応する1.6版の文書を参照しています。
- Scikit-learn 1.6:よくある問題、学習データだけを使う変換、データ漏洩
- Scikit-learn 1.6:TimeSeriesSplitとサンプル数で定義するgap
- Scikit-learn 1.6:LogisticRegressionの設定と確率のクラス順序
- Scikit-learn 1.6:分類と確率予測の評価指標
- humblefool06:BTC-USDTの4時間足アーカイブ、固定した公開リビジョン、ライセンス宣言
- Binance現物API:ローソク足の日時と市場データのエンドポイント
- Baileyほか:バックテスト過剰適合の確率
- Politis・White:依存データのブートストラップにおけるブロック長の自動選択。円形再標本化を含む
- OpenAI:コード生成とCodexによる開発のガイド
- Anthropic:Claude Codeの概要
変動コストと理想化した約定を使う、過去データによる教育目的の研究です。ライブ取引、独立した専門家の査読、AI間の投資比較実験は行っていません。過去の結果や再標本化した結果は、将来の収益性を証明しません。