Python으로 미래 정보 참조 편향 없이 머신러닝 매매 전략 백테스트하기
실행한 Python 머신러닝 백테스트: 확정된 라벨, 월별 학습, 정보 시점 검사, 실제 거래 회계와 비용 후 손실을 보고합니다. 미래 입력 없이 여섯 특징을 사용합니다.
머신러닝 매매 전략은 각 판단 시점에 이용 가능했던 정보를 복원해 백테스트해야 합니다. 완성된 특징, 이미 결과가 확정된 학습 라벨, 학습 데이터만으로 적합한 전처리, 신호 이후의 체결이 필요합니다. 비트코인 일봉 로지스틱 회귀 전략으로 이 절차를 실행했습니다. 2024~2025년 가정한 비용 후 수익률은 −1.67%였고, 초기 배분 매수 후 보유 기준선은 +96.28%였습니다. 미래 수익률을 입력한 의도적으로 잘못된 구현은 +867.06%를 번 것처럼 보였습니다. 수익성을 해석하기 전에 정보 이용 달력을 검사해야 하는 이유입니다.
이 연구에서 확인한 것
- 시간순 분할에도 누출은 생길 수 있습니다. 월별 경계마다 학습 후보 다섯 행의 라벨이 아직 확정되지 않았습니다.
- 이용 가능한 과거 행만으로 새 스케일러와 모델을 매달 적합했습니다. 이전 평가 라벨도 관측 가능해진 뒤에만 후속 학습에 들어갔습니다.
- 미래 관측을 바꿔도 올바른 구현의 이전 예측과 주문은 같았고, 잘못된 대조 구현은 검사에 실패했습니다.
- 고정 전략은 수수료·슬리피지 없이 +17.51%였지만, 청산 거래 66건에서 비용 후 −1.67%를 기록했습니다.
- 예측 점수, 손실 거래, 개발 조합 아홉 개, 조건부 부트스트랩 경로를 통해 이 결과로 실자금 투입을 정당화할 수 없는 이유를 설명합니다.
시각부터 정한 뒤, 그 예측이 가능했는지 묻는다
이전 미래 정보 참조 편향 가이드는 흔한 실패를 설명합니다. 이번에는 실제로 적합하는 머신러닝 파이프라인을 만들고 실행해, 예측이 현금 계좌에 반영되는 과정을 추적합니다. 질문은 구체적입니다. 완성된 일봉 가격·거래량 특징 여섯 개가 단순한 모델로 비용 후 수익성 있는 5일 비트코인 거래를 선택하는 데 도움이 될까요?
첫 유용한 검사는 구체적인 통과 사례입니다. 2024년 1월 1일 종가가 확정된 시점에 사용할 수 있는 최신 학습 특징 날짜는 2023년 12월 26일입니다. 그 결과는 12월 27일 시가부터 1월 1일 시가까지여서 이미 알려져 있습니다. 12월 27일 특징 행은 1월 2일 시가가 필요하므로 제외해야 합니다. 실행한 적합에는 12월 26일까지 725행이 들어가며, 1월 1일 특징 행의 예측은 0.452770으로 고정 매매 기준 0.55보다 낮습니다.
재현했다는 구현이 12월 31일까지 학습한다면 이익보다 먼저 라벨 종료 필터를 확인하세요. 확률이 다르면 UTC 일봉 입력, 특징 순서, 스케일러 통계와 패키지 버전을 비교하세요. 매력적인 최종 곡선을 믿으라고 하기보다 시작 부분에 디버깅 기준을 둡니다. 전체 구현, 프로토콜, 출처가 있는 입력, 적합 기록과 거래 원장은 저장소 연구 기록에 보존합니다.
수익률을 재기 전에 가설과 계좌 규칙을 고정한다
경제적 가설은 의도적으로 소박합니다. 최근 수익률, 변동성, 가격 범위, 상대 활동량에 다음 5일 시가 간 움직임에 대한 정보가 있어 반복되는 왕복 비용을 보상할 수도 있다는 것입니다. 로지스틱 회귀는 계수별로 살펴보기 쉽습니다. 검증할 만한 가설이지만 우위의 증거는 아닙니다.
이번 성과를 계산하기 전에 프로토콜과 설정을 기록했습니다. C = 1과 기준값 0.55는 고정했으며 가장 좋은 결과에서 고르지 않았습니다. 제한된 개발 그리드는 뒤에 공개합니다. 개발·평가 가격은 이전 TensorParadigm 프로젝트에서 이미 다뤘으므로, 미사용 발견 표본이 아니라 과거 자료로 방법을 보여 주는 연구입니다.
| 판단 항목 | 고정 명세 |
|---|---|
| 시장과 시간 | BTCUSDT, UTC 일봉, 현물과 유사한 매수 보유/미보유 현금 계좌 |
| 예측 | 종가 t 확정 시 open[t+6] / open[t+1] − 1 > 0일 확률 |
| 학습 | 매월 이전 730일, 확정 라벨만 사용, 완전한 행 252개 이상과 두 클래스 필요 |
| 모델 | StandardScaler → LogisticRegression, C = 1, lbfgs, max_iter = 2000 |
| 진입과 청산 | 미보유 상태에서 p ≥ 0.55면 시가 t+1에 매수, 시가 t+6에 매도, 청산 체결 당일 신호 없음 |
| 수량 | 진입 수수료 포함 가용 현금의 90%, 소수 BTC, 단일 포지션, 레버리지 없음 |
| 매수·매도 각각 비용 | 수수료 10베이시스포인트, 불리한 체결 5베이시스포인트, 스프레드 추가 차감 없음 |
| 개발 | 2021년, 일봉 365개, 이전의 2020년 관측으로 초기 학습 |
| 검증 | 2022~2023년, 730봉, 미보유 상태에서 시작하는 연간 구간도 보고 |
| 평가 | 2024~2025년, 731봉, 월별 재적합 절차와 설정 고정 |
모든 기간은 10,000 USDT와 미보유 상태로 시작합니다. 다음 모델 예측이 달라도 예정된 5일 뒤 청산은 유지합니다. 마지막 허용 진입 신호는 알려진 달력으로 정해 모든 전략 거래가 보고 기간 안에 끝나게 합니다. 마지막 여섯 날짜에는 예측을 낼 수 있지만 새 거래를 시작하거나 미확정 결과를 그 기간의 분류 점수에 넣지는 못합니다.
데이터가 무엇을 나타내며 무엇이 미검증인지 확인한다
입력은 2020년 2월 20일부터 2025년 12월 31일까지 완전한 일봉 2,142개입니다. humblefool06의 BTC-USDT 4시간봉 아카이브를 리비전 9f491eb5340dd6a24f27fde24edf098e1e785443으로 재사용하며, 게시자는 CC BY 4.0을 선언합니다. 일봉은 UTC 관측 여섯 개에서 첫 시가, 최고 고가, 최저 저가, 마지막 종가, 기준 자산 거래량 합계를 구해 만듭니다. 앞선 불완전한 하루는 제외합니다. 정규화 CSV의 SHA-256은 43655a51e6cb41c2ee087bd947f4cefb7dd4151617a29d7f75a3cda471ae5cbb입니다. [5]
이전 연구가 보존한 2026년 10월 18일 대조에서는 평가 기간 731개 캔들, OHLCV 3,655개 셀 모두가 십진수 비교로 Binance 일봉 엔드포인트와 일치했습니다. 같은 입력과 함께 그 기록을 이어받았으며, 이 글을 위한 새로운 독립 감사는 하지 않았습니다. 아카이브는 원래 어느 거래소에서 온 것인지 명시하지 않습니다. Binance와의 일치는 가격이 같다는 사실만 보여 줍니다. 별도 거래소의 데이터까지 확인했거나 원천 거래소를 특정했다는 뜻은 아닙니다. 2020~2023년 학습·검증 관측은 외부 대조가 되지 않았습니다. Binance는 시작 시각으로 캔들을 식별하며 표의 일별 날짜는 UTC 세션을 뜻합니다. [6]
프로그램은 날짜의 유일성과 오름차순, 끊김 없는 일별 간격, 유한한 OHLCV, 양의 가격, 일관된 고가·저가 경계를 검사합니다. 이런 검사는 잘못된 형식을 잡지만 모든 잘못된 관측을 잡지는 못합니다. 살아남은 암호자산 한 종목으로 과거 투자 가능 종목군의 성과를 알 수도 없습니다. 보고한 계산에는 Python 3.13.3, pandas 2.2.3, NumPy 2.2.6, scikit-learn 1.6.1을 사용했습니다.
미래 가격은 결과를 정의할 때만 쓰고 예측 입력에는 쓰지 않는다
여섯 입력은 1일·5일·20일 종가 수익률, 최근 20개 1일 수익률의 모집단 표준편차, 완성된 하루의 고가·저가 차이를 종가로 나눈 값, 거래량을 후행 20일 평균으로 나눈 뒤 1을 뺀 값입니다. 모든 구간에 방금 완성된 세션이 들어갑니다. 준비 기간이 부족한 행은 뒤의 값으로 채우지 않고 버립니다. 현재 종가는 종가 이후 판단에는 유효하지만 같은 날의 이전 시가 판단에는 이용할 수 없습니다.
다음 특징 식은 실행한 Python 구현의 일부입니다. 후행 구간이 필수입니다. 중앙 정렬 구간으로 바꾸거나 전체 이력으로 변환을 추정하면 판단 때 이용하는 정보가 달라집니다. scikit-learn의 누출 지침도 학습 부분집합에서만 변환을 학습하도록 요구합니다. [1]
returns = close.pct_change(fill_method=None)
X = pd.DataFrame({
    "return_1": returns,
    "return_5": close.pct_change(5, fill_method=None),
    "return_20": close.pct_change(20, fill_method=None),
    "volatility_20": returns.rolling(20).std(ddof=0),
    "range_to_close": (high - low) / close,
    "relative_volume_20": volume / volume.rolling(20).mean() - 1,
})
타깃은 예측할 결과를 나타내므로 미래 시가를 사용합니다. 라벨 1은 비용 전 청산 시가가 진입 시가를 초과한다는 뜻이고, 같으면 클래스 0입니다. 수수료 후 거래 이익이라는 뜻은 아닙니다. 아래 음수 이동은 타깃 구성에만 사용합니다. 마지막 미확정 결과는 결측으로 남깁니다. 비교만 적용하면 알 수 없는 결과가 잘못된 클래스 0 관측으로 조용히 바뀝니다.
target_return = open_price.shift(-6) / open_price.shift(-1) - 1
y = (target_return > 0).where(target_return.notna())
label_end = X.index + pd.Timedelta(days=6)

train_mask = (
    (X.index >= fit_date - pd.Timedelta(days=730))
    & (X.index < fit_date)
    & (label_end <= fit_date)
    & y.notna()
    & X.notna().all(axis=1)
)
학습 라벨이 미래까지 이어지면 날짜 분할만으로 부족하다
2024년 1월 1일 종가에서 단순한 이전 730일 필터는 2022년 1월 1일부터 2023년 12월 31일까지 특징 날짜를 선택합니다. 다섯 행은 사용할 수 없습니다. 그 결과가 2024년 1월 2~6일에 끝나기 때문입니다. 확정 조건으로 제거하면 12월 26일까지 725개 관측이 남습니다. 평가 기록의 월별 적합마다 같은 다섯 행이 제외됩니다.
그림은 이미 관측한 결과와 판단 경계를 넘는 결과를 구분합니다. 날짜는 지어낸 가격 경로가 아니라 실제 프로토콜입니다. 양쪽 모두 글에서는 1월이지만, 1월 1일 시가는 그날 종가에 이용 가능하고 1월 2일 시가는 아닙니다.
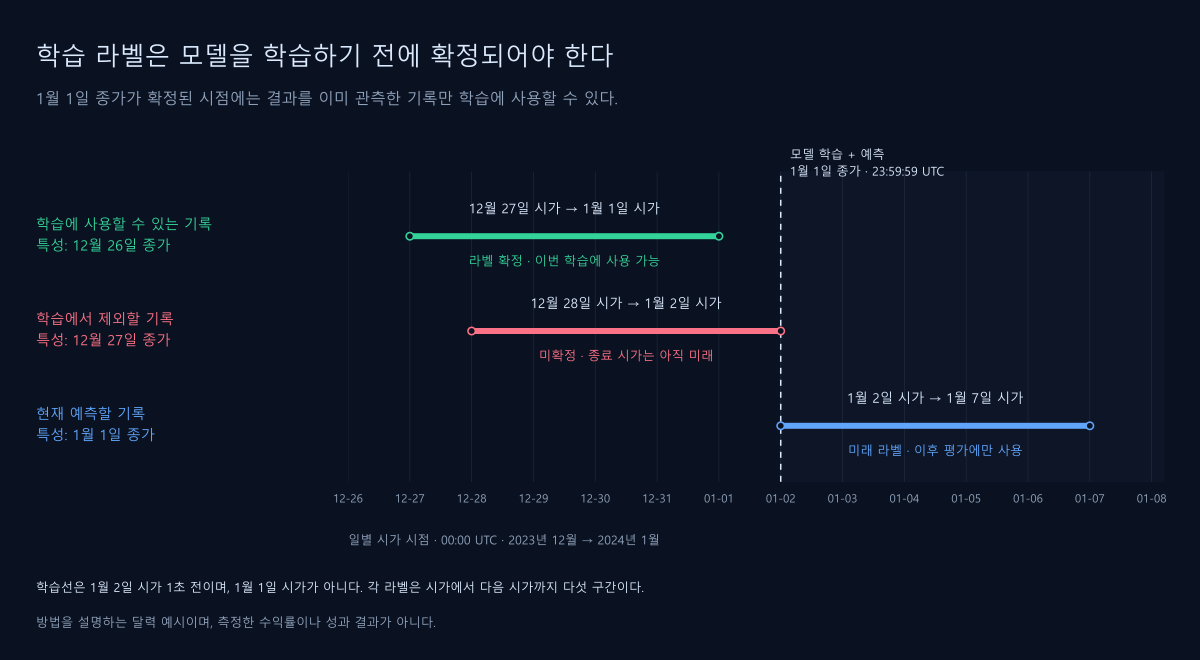
이 완전한 일별 달력에서 첫 테스트 특징 날짜가 t인 TimeSeriesSplit은 마지막 학습 특징을 t−6으로 만들려면 표본 다섯 개의 gap이 필요합니다. 여섯 표본이면 보수적입니다. scikit-learn은 gap을 지난 달력 시간이 아니라 표본 수로 정의합니다. 보유 기간 변화, 누락 세션, 지연 데이터가 있다면 이 정수를 복사하지 말고 실제 이용 가능 시각을 써야 합니다. 기록한 적합에는 TimeSeriesSplit 대신 명시적인 라벨 종료 마스크를 사용했습니다. [2]
이 전진 매매 실험은 시간 순서를 지켜야 합니다. 시계열 통계에서 무작위 교차검증을 쓰는 모든 경우에 대한 일반 주장은 아닙니다. 여기서는 인접한 5일 결과가 겹치고, 테스트 집합 이전 행에도 아직 이용할 수 없는 타깃이 들어갈 수 있습니다. 학습 경계 누출을 제거해도 나머지 테스트 결과가 통계적으로 독립이 되는 것은 아닙니다.
같은 이용 가능한 학습 구간 안에서 스케일러와 분류기를 적합한다
매월 첫 예측일에 새 파이프라인을 만들고, 결과가 확정된 후행 행만으로 적합한 뒤 다음 월별 적합까지 상태를 보존합니다. 오늘 특징 행은 적합된 통계로 변환하며 스케일러 적합에는 추가하지 않습니다. 파이프라인은 경계를 지키는 데 도움이 되지만 미래에서 온 특징이나 잘못 선택한 학습 집합을 고치지는 못합니다. [1]
pipeline = Pipeline([
    ("scale", StandardScaler()),
    ("model", LogisticRegression(
        C=1, solver="lbfgs", max_iter=2000, random_state=6142026
    )),
])
pipeline.fit(X.loc[train_mask], y.loc[train_mask].astype(int))
assert pipeline.named_steps["model"].classes_.tolist() == [0, 1]
p_up = pipeline.predict_proba(X.loc[[signal_date]])[0, 1]
C는 규제 강도의 역수이므로 작을수록 규제가 강합니다. 양성 확률 열은 classes_ = [0, 1]과 확인합니다. 특징 순서, 학습 행 해시, 스케일러 평균과 척도, 계수, 절편, 최적화 반복 횟수를 기록합니다. lbfgs 솔버를 사용하므로 random_state를 전달했다는 사실이 결정성을 설명하지는 않습니다. [3]
월별 재적합은 이전 평가 결과도 확정된 뒤에 정당하게 사용합니다. 예를 들어 2월 적합은 이용 가능한 1월 관측에서 학습할 수 있습니다. 2년 내내 고정한 단일 모델이 아니라, 고정된 갱신 절차를 시간의 앞쪽으로 평가한 것입니다. 이후 평가 결과로 C, 기준값, 특징, 재적합 일정을 바꾸지 않았습니다. 그 선택을 다시 조정하려면 새 평가 프로토콜이 필요합니다.
predict_proba를 믿기 전에 첫 채택 예측을 복원한다
첫 채택 평가 신호는 2024년 1월 12일 종가에 발생합니다. 여전히 1월 1일 적합을 쓰며, 2022년 1월 1일부터 2023년 12월 26일까지 725행을 사용합니다. 최신 학습 결과는 1월 1일 시가에 끝납니다. 표는 실제 특징 벡터, 학습 통계로 표준화한 값, 적합 계수를 보여 줍니다. 표시는 반올림했지만 감사에는 전체 정밀도를 씁니다.
| 특징 | 원래 값 | 표준화 z | 계수 |
|---|---|---|---|
| return_1 | −0.076748 | −2.672794 | −0.103549 |
| return_5 | −0.026094 | −0.417899 | −0.111867 |
| return_20 | −0.021039 | −0.200837 | +0.039253 |
| volatility_20 | 0.030521 | 0.420563 | +0.026111 |
| range_to_close | 0.117233 | 2.754973 | −0.019805 |
| relative_volume_20 | 0.778955 | 1.552860 | +0.037502 |
특징마다 z = (x − 학습 평균) / 학습 척도입니다. 절편 0.014133035에 z와 계수의 곱을 모두 더하면 로짓 0.344416426이 됩니다. 1 / (1 + exp(−로짓))를 적용하면 0.585262925입니다. 0.55보다 높으므로 미보유 계좌는 1월 13일 시가 매수를 제출합니다. 이는 모델상 비용 전 가격 상승 확률이지 보정된 거래 순이익 확률이 아닙니다.
첫 평가일 확률 0.452769888은 올바르게 거래를 만들지 않습니다. 이 두 감사 지점은 특징·적합 차이와 주문 처리 차이를 구분하는 데 도움이 됩니다. 예측이 맞더라도 체결, 현금 수량 산정, 청산 시계가 잘못되면 백테스트는 잘못될 수 있습니다.
예측과 주문, 현금 계좌를 분리한다
조건을 충족한 종가 신호는 다음 시가 진입과 그로부터 5일 뒤 시가 청산을 예약합니다. 시뮬레이션은 실제 체결 때 현금을 배분합니다. 수량 = 0.90 × 현금 / (매수 체결가 × 1.001)입니다. 브로커 쪽의 현금 배분이지, 어제 알 수 없었던 내일 시가로 계산한 수량이 아닙니다. 매수 체결가는 원시 시가 × 1.0005, 매도 체결가는 원시 시가 × 0.9995입니다. 각 수수료는 슬리피지를 반영한 거래대금의 0.001배입니다.
if flat and not exited_today and p_up >= 0.55:
    entry_date = signal_date + pd.Timedelta(days=1)
    exit_date = signal_date + pd.Timedelta(days=6)
    if exit_date <= evaluation_end:  # known calendar, not future prices
        pending_buy = (entry_date, exit_date)

# At the entry open:
fill = open_price * 1.0005
quantity = 0.90 * cash / (fill * 1.001)
일별 종가에서 순자산은 현금과 BTC 수량 × 원시 종가의 합입니다. 낙폭은 초기 잔액을 포함한 일별 종가 계좌의 누적 최고점에서 측정합니다. 슬리피지는 이미 가격에 들어가므로 다시 차감하지 않습니다. 모든 전략 포지션은 보고 기간 안에 끝납니다. 반면 매수 후 보유는 마지막 종가에도 BTC를 보유하며, 진입 수수료를 포함하고 가상의 청산 수수료는 넣지 않습니다.
암호자산 일별 종가와 다음 시가는 맞닿아 있습니다. 바로 그 다음 시가의 체결은 이상화한 가정입니다. 이 연구는 모델 계산, 거래소, 네트워크 지연이 달성 가능한지 입증하지 않습니다. 5베이시스포인트는 민감도 가정이며 호가장에서 관측한 값이 아닙니다. 레버리지, 공매도, 손절, 펀딩비, 현금 이자, 세금, 고정 운영비, USDT 환전을 제외하며 소수 수량은 거래소 필터를 무시합니다. 이 선택들이 시뮬레이션 범위를 정합니다.
고정 모델은 비용 후 손실이며 단순 보유 기준선에 뒤진다
비용 전 결과는 수수료와 슬리피지를 모두 0으로 한 별도 계좌 실행에서 나옵니다. 비용 후 결과는 매수·매도 각각 고정한 10+5베이시스포인트 가정을 사용합니다. 개발·검증·평가 계좌는 각각 10,000 USDT로 시작합니다. 표는 적합된 기대값이 아니라 측정 결과를 보고합니다.
| 기간 | 비용 전 ML 수익률 | 순 ML 수익률 | ML 최대 낙폭 | 청산 거래 | 순 매수 후 보유 |
|---|---|---|---|---|---|
| 개발 2021년 | +26.88% | +10.56% | 41.81% | 51 | +53.60% |
| 검증 2022~2023년 | −40.06% | −46.76% | 54.13% | 44 | −7.78% |
| 평가 2024~2025년 | +17.51% | −1.67% | 27.82% | 66 | +96.28% |
평가 머신러닝 계좌는 미청산 BTC 없이 9,832.51 USDT로 끝나며, 청산 거래 손익은 −167.49 USDT입니다. 평균 투자 비중이 40.63%인데도 최대 일별 종가 낙폭 27.82%는 매수 후 보유의 30.86%보다 약간 낮을 뿐입니다. 731번의 일별 종가 중 330번 BTC를 보유합니다. 노출이 낮다고 자동으로 매력적인 위험조정 대안이 되지는 않습니다.
두 의사결정 기준선은 같은 5일 보유·휴지·수량·비용 규칙을 사용합니다. 완성된 20일 수익률이 양수일 때 매수하면 71건에서 −11.63%, 낙폭 33.99%입니다. 월별 확정 학습 표본의 양성 라벨 빈도가 0.55에 도달할 때 매매하면 36건에서 −26.56%, 낙폭 37.85%입니다. 머신러닝 규칙은 여기서 이 두 방침을 이기지만 손실을 내며 보유 기준선에 크게 뒤처집니다. 특징이 지속적인 경제적 우위를 더한다는 증거로는 부족합니다.
그림의 계좌는 실제 계산한 일별 순자산을 사용합니다. 매수 후 보유는 기간 첫 시가에 같은 진입 비용으로 90%를 투자하고 현금 10%를 남깁니다. 훨씬 큰 시장 노출도 비교의 일부이며 머신러닝의 인과적 기여를 통제해 추정한 것은 아닙니다. 더 넓은 해석은 머신러닝과 규칙 기반 매매 연구를 참고하세요.
예측 정확도는 거래 수익성과 다른 측정이다
결과가 완전히 관측된 평가 예측 725개를 평가하며, 이미 BTC를 보유한 동안의 예측도 포함합니다. 나머지 여섯 결과는 기간 밖으로 이어져 제외합니다. 양성 라벨은 390개, 53.79%입니다. 빈도 기준선은 여섯 특징 없이 월별 확정 학습 라벨의 양성 비율을 예측합니다.
정확도는 분류 경계 0.50을, 주문은 0.55를 사용합니다. Brier 점수는 확률 오차의 제곱, 로그 손실은 확률 오류에 대한 로그 벌점, ROC AUC는 순위를 측정합니다. 수량 산정이나 수수료는 포함하지 않습니다. Brier 점수가 낮다고 보정이 더 좋다는 뜻도 아닙니다. 보정 외의 요소도 반영하기 때문입니다. 확률을 별도로 보정하지 않았습니다. [4]
| 평가 예측 | 0.50 기준 정확도 | Brier ↓ | 로그 손실 ↓ | ROC AUC |
|---|---|---|---|---|
| 여섯 특징 로지스틱 회귀 | 50.76% | 0.251416 | 0.695919 | 0.502044 |
| 확정 학습 빈도 기준선 | 53.79% | 0.249933 | 0.693033 | 0.476881 |
머신러닝 모델은 빈도 기준선의 Brier 점수나 로그 손실을 개선하지 못합니다. AUC 0.5020은 0.5에 가깝지만 겹치는 결과에 독립 관측을 가정한 유의성 주장은 붙이지 않습니다. 예측 725개가 독립 거래 725건인 것도 아닙니다. 계좌는 실제로 66건을 청산합니다. 작은 점수 차이는 경제적 결과를 뒤집을 만한 설득력 있는 예측 근거가 아닙니다.
첫 손실 거래를 양쪽 체결과 현금 잔액까지 추적한다
1월 12일 예측 0.585262925가 첫 거래를 일으킵니다. 1월 13일 원시 진입 시가는 42,782.74 USDT입니다. 5베이시스포인트 불리한 체결을 반영하면 매수 체결가는 42,804.131370입니다. 수량은 0.210050027959 BTC, 진입 거래대금은 8,991.008991 USDT, 수수료는 8.991009이며 현금이 정확히 1,000 USDT 남습니다.
의무적인 1월 18일 청산은 원시 시가 42,776.09와 매도 체결가 42,754.701955를 사용합니다. 수수료는 8.980626 USDT입니다. 슬리피지가 들어간 체결가 사이의 가격 손익은 −10.382650이고 두 수수료를 빼면 −28.354285 USDT입니다. 최종 현금은 9,971.645715입니다. 초기 10,000 및 미보유 상태와 맞으며 모델 확률이 예정 청산을 뒤집지 않았습니다.
평가 거래 66건 중 비용 후 이익은 32건, 손실은 34건으로 승률은 48.48%입니다. 평균 이익은 +332.83 USDT, 평균 손실은 −318.18로 손익비는 약 1.05입니다. 평균 거래 손익은 −2.54 USDT, 수익계수는 0.9845입니다. 승률이나 비용 전 방향 예측만으로 현금 결과를 설명할 수 없습니다. 수수료, 체결가, 달라지는 자본, 손익 크기가 함께 결정합니다.
수익이 좋아 보여도 누출 모델은 검사에 실패하게 한다
2024년 6월 15일 이후의 모든 관측에서 OHLC 가격을 두 배, 거래량을 세 배로 바꾸고 이전 값은 고정했습니다. 올바른 모델을 재구축해도 과거 특징, 이용 가능한 학습 행렬, 스케일러·모델 상태, 예측, 판단, 체결은 변하지 않았습니다. 이전 확률 차이의 최댓값은 정확히 0이었습니다. 이 구현에서 실행한 불변성 검사이며 가능한 모든 편향이 제거되었다는 증명은 아닙니다.
changed = bars.copy()
future = changed.index > cutoff
changed.loc[future, ["open", "high", "low", "close"]] *= 2
changed.loc[future, "volume"] *= 3
# Valid: past features, fit states, predictions and orders are identical.
# INVALID control: X also contains target_return, so this check fails.
음성 대조 구현은 실현된 미래 시가 간 수익률을 일곱 번째 입력으로 의도적으로 추가합니다. 같은 월별 파이프라인과 계좌 규칙을 유지하지만 예측 시점의 정보 이용 가능성을 위반합니다. 겉보기 순수익률 +867.06%, 분류 정확도 97.66%, AUC 0.998676을 보고합니다. 이는 무효(INVALID) 백테스트의 측정값이지 전략 후보나 선택에 사용한 결과가 아닙니다.
같은 미래 변형은 잘못된 모델의 이전 확률을 최대 0.998626629 바꿉니다. 깨끗한 스케일러, 시간순 적합, 그럴듯한 주문 회계도 사용할 수 없는 입력을 구하지 못한다는 대조입니다. 반면 경계의 미확정 라벨 다섯 개는 더 조용한 오류입니다. 눈에 띄는 성과 변화 없이도 달력만으로 잘못임을 알 수 있습니다.
연구 테스트는 후행 특징 시점, 마지막 결측 라벨, 정확한 라벨 확정 경계, 학습 전용 표준화, 월별 적합 재사용, 분류 기간 경계, 겹치지 않는 주문, 청산일 휴지, 수수료 포함 수량, 현금·손익 대조, 결정적인 블록 재표집도 검사합니다. 정보 순서 검사는 알려진 잘못된 버전에서 실패해야 합니다. 코드가 실행된다는 관찰만으로는 증거가 약합니다.
개발 그리드를 공개하고 실망스러운 검증 구간도 남긴다
개발 조합은 C {0.1, 1, 10}과 진입 기준 {0.50, 0.55, 0.60}의 아홉 가지로 제한했습니다. 표는 2021년 순수익률입니다. 기준이 바뀌면 매력이 떨어지는 조합도 모두 남깁니다. 다른 개발 설정이 더 좋아 보여도 사전 선언한 C = 1, 기준값 = 0.55가 이 글의 전략입니다.
| C | 기준 0.50 | 기준 0.55 | 기준 0.60 |
|---|---|---|---|
| 0.1 | +7.81% | +10.56% | +25.24% |
| 1 | +7.81% | +10.56% | +55.01% |
| 10 | +7.81% | +10.56% | +55.01% |
기준값 0.50과 0.55에서는 세 C 모두 같은 실행 거래 경로를 만듭니다. 확률도 같다는 뜻은 아닙니다. 0.60에서는 C = 0.1 경로가 다릅니다. 기준값 변경은 거래 허용과 이후 휴지 기회를 바꾸므로 작은 예측 차이도 복리 수익률을 바꿀 수 있습니다. 이 그리드로 시장 기간 전반에 안정적으로 수익을 내는 영역을 찾았다고 할 수는 없습니다.
검증에는 월별 롤링 적합을 포함한 고정 절차를 씁니다. 독립 연간 계좌는 2022년 37건에서 −44.04%, 2023년 일곱 건에서 −4.87%를 잃습니다. 최대 낙폭은 54.13%와 8.60%입니다. 각자 연말 달력 제외를 가진 미보유 시작 구간이므로 수익률을 복리로 연결해도 연속 2022~2023년 계좌와 정확히 같지는 않습니다. 연속 평가 계좌에서 2024년 수익률은 −1.14%, 2025년은 −0.54%입니다.
과거 최선 조합을 선택하는 것은 고정 규칙 하나를 평가하는 것과 다른 연구 절차입니다. Bailey와 공저자들은 여러 백테스트 중 선택이 과최적화로 이어지는 과정을 정식화합니다. 작은 그리드와 불리한 구간을 공개하지만 아홉 설정으로 정식 백테스트 과최적화 확률을 추정한다고 주장하지 않습니다. 이 보고 후 설정을 바꾸면 해당 기간은 개발 증거가 됩니다. [7]
회전 매매가 비용 전 이익을 소모하고 몇몇 거래가 크게 좌우한다
평가 계좌는 132번 체결합니다. 매수·매도 거래대금 합계는 초기 순자산의 122.29배입니다. 이 편도 회전율 정의는 양쪽을 포함하며 전체 계좌를 122번 왕복 회전했다는 뜻은 아닙니다. 총수수료는 1,222.92 USDT, 원시 시가 대비 가격에 포함된 체결 손실분은 611.46 USDT입니다. 비용 변경은 후속 수량도 바꾸므로 이 원장 합계를 별도 비용 전 계좌에서 빼는 것으로 순결과를 정확히 복원할 수는 없습니다.
민감도 표는 매수·매도 각각 수수료 10베이시스포인트와 모델 판단을 유지하고 불리한 슬리피지만 바꿉니다. 슬리피지가 0이어도 +4.34%에 불과하며 10베이시스포인트에서는 −7.34%입니다. 따라서 충분한 체결 여유가 있다고 입증하지 못합니다. 수수료·슬리피지 없는 +17.51%는 회계 이해에는 유용하지만 달성 가능한 순수익률 예측이 아닙니다.
| 매수·매도 각각 수수료 | 매수·매도 각각 슬리피지 | 순 평가 수익률 | 최대 낙폭 |
|---|---|---|---|
| 10 bp | 0 bp | +4.34% | 27.37% |
| 10 bp | 5 bp | −1.67% | 27.82% |
| 10 bp | 10 bp | −7.34% | 28.27% |
| 10 bp | 20 bp | −17.72% | 30.67% |
가장 큰 순이익 거래 세 건이 +2,764.12 USDT를 기여합니다. 나머지 청산 거래 합계는 −2,931.61입니다. 관측 원장에 대한 기술적 집중도 계산이지 그 거래를 없애고 이후 현금을 바꾼 재실행은 아닙니다. 개선안은 사전에 이용 가능한 정보로 이익을 유지하거나 회전율을 줄이는 방법을 설명해야 합니다. 과거 손실 거래 삭제는 또 다른 편향된 결과를 만들 뿐입니다.
새 증거를 만든 척하지 않고 계좌 경로를 재표집한다
미보유일을 포함한 일별 계좌 순수익률에서 연속 20일 원형 블록을 뽑아 각 경로가 731일이 될 때까지 이어 붙여 조건부 경로 5,000개를 만들었습니다. 시드 6142026으로 계산을 고정합니다. 표본 끝에서 처음으로 돌아가 연속 블록을 유지하면 일부 국소적 의존성이 보존됩니다. Politis·White가 설명한 원형 재표집 구성을 쓰지만 블록 길이는 20일로 고정했고 자동 선택 방법은 사용하지 않았습니다. 이 선택이 관련 의존성을 모두 포착하거나 수익률 과정이 정상성을 갖는다고 보장하지는 않습니다. [8]
최종 수익률의 5백분위, 중앙값, 95백분위는 −42.11%, −1.03%, +61.61%입니다. 최대 낙폭에서는 16.79%, 30.26%, 51.19%입니다. 재표집 경로의 51.44%가 초기 순자산보다 낮게 끝납니다. 이 비율은 과거 표본과 재표집 규칙에 조건부이며 현실에서 전략이 손실을 낼 확률의 추정값이 아닙니다.
이 부트스트랩은 실현된 계좌 수익률 시계열을 재배열합니다. 가격을 다시 만들거나 모델을 재적합하거나 주문을 재계산하지 않으므로 표집 순서가 실행 가능한 매매 이력일 필요는 없습니다. 일어난 일을 조건으로 경로 민감도를 탐색합니다. 경로를 늘리면 시뮬레이션 잡음은 줄지만 새 시장 관측, 독립 거래, 예측 우위의 증거는 추가되지 않습니다.
AI 협업자에게 실제 확인 가능한 통과 조건을 준다
ChatGPT나 Claude는 매매 아이디어를 정확한 명세로 만들고 모호함을 지적하는 데 도움을 줄 수 있습니다. Codex나 Claude Code는 저장소 파일을 다루고 계산을 실행하며 실패를 살필 수 있습니다. 공식 제품 문서는 이런 개발 역할을 뒷받침하지만 어느 기능도 매매 우위를 입증하지는 않습니다. 이번 프로젝트는 Codex의 도움과 로컬 Python 계산을 사용했습니다. 통제된 ChatGPT 대 Claude 비교, LLM 시장 예측, 독립 전문가 검토는 하지 않았습니다. [9] [10]
아래 프롬프트는 서로 다른 네 가지 일을 검토 가능하게 합니다. 매 요청에 고정 명세와 관련 코드를 제공하세요. 시장 데이터가 관측을 주고 실행 가능한 프로그램이 계산하며, 가정과 증거가 새 검증을 정당화하는지는 연구자가 판단합니다. 자신 있는 서술은 대조가 끝난 원장을 대신할 수 없습니다. 넓은 개발 과정은 매매 알고리즘 만들고 검증하기를 참고하세요.
UTC 일봉 BTCUSDT의 매수 보유/미보유 머신러닝 실험을 명세하세요. 확정 종가 t에서 open[t+6]/open[t+1]-1의 부호를 예측합니다. 특징별 이용 가능 시점, 타깃 확정, 월별 학습 구간, 진입·청산 달력, 현금 수량 산정과 비용을 정의하세요. 재적합과 하이퍼파라미터 선택을 분리하세요. 모호함을 나열하고 2024-01-01 종가에서 이용 가능한 최신 학습 특징 날짜를 제시하세요. 성과를 계산하거나 수익률에서 설정을 고르지 마세요.첨부한 고정 명세를 특징·라벨, 월별 적합, 현금 계좌 함수로 나눠 구현하세요. StandardScaler는 확정된 학습 범위 안에서만 적합하세요. 마지막 결측 라벨을 보존하세요. 적격 날짜, 특징 순서, 스케일러 상태, 계수, 확률, 판단, 체결을 기록하세요. C=1이나 기준값=0.55를 다시 조정하지 마세요. 미래 OHLCV 변경에도 이전의 올바른 예측·주문이 모두 유지되는 테스트를 추가하고, 의도적인 target_return 특징은 실패함을 보이세요.전략을 바꾸지 말고 2024-01-12 신호를 감사하세요. 2024-01-01 적합에서 표준화 특징, 로짓, 확률을 복원하세요. 수수료 10베이시스포인트와 불리한 체결 5베이시스포인트로 1월 13일 진입과 1월 18일 청산을 추적하세요. 수량, 현금, 양쪽 수수료, 순손익을 보여 주세요. 초기 현금에 청산·미청산 시가평가 손익을 더해 최종 순자산과 대조하세요. 최종 수익률만 설명하지 말고 최초로 다른 기록을 확인하세요.기록된 출력으로 연구 보고서를 쓰세요. 모든 개발 조합, 시간순 기간, 비용 전후 수익률, 기준선, 예측 점수, 낙폭, 노출, 회전율, 거래 손익의 비대칭, 비용, 집중도를 포함하세요. 겹치는 라벨과 조건부 블록 부트스트랩의 한계를 설명하세요. 미래 특징 대조는 보고하는 모든 곳에 무효(INVALID)라고 표시하세요. 실행한 계산, 설명용 발췌, 미실행 요소를 구분하세요. 과거 가격에 대한 사전 지식과 데이터 검증 한계를 공개하세요. 수익성 있는 제목을 얻으려고 최적화하지 마세요.이 롤링 scikit-learn 파이프라인에 맞는 Pine 구현을 제공하거나 실행하지 않았습니다. 한 달의 적합 계수만 복사하면 다른 고정 전략이 됩니다. 충실한 비교는 학습 구간, 스케일링, 라벨 확정, 재적합과 체결 의미를 재현해야 합니다. 연구 범위의 한계이지 Pine이 머신러닝 계산을 표현할 수 없다는 주장이 아닙니다. Python·Pine 백테스트 연구는 신호 공식 일치만으로 부족한 이유를 설명합니다.
정당한 다음 단계는 실전 투입이 아니라 기록된 전향적 검증이다
구현은 검사한 정보 순서 속성을 통과하지만 고정 전략은 비용 후 손실이며, 주요 확률 점수를 개선하지 못하고 검증 기간에 심한 낙폭을 겪습니다. 실자금 투입을 정당화하지 못합니다. 이 글의 유용한 결과는 유효한 과거 측정과 수익성 있어 보이는 정보 누출을 구분하는 방법입니다.
연구를 계속한다면 새 전향적 모의매매 구간을 시작 전에 기록하세요. 특징 집합, 확정 규칙, 재적합 달력, 비용과 보고 기준을 고정하세요. 완성 입력, 적합 상태, 신호, 가능한 다음 체결에 시각을 붙이고 실제 지연과 제시 스프레드를 측정하세요. 학습 빈도 예측과 단순 보유 계좌 모두와 비교하세요. 제안한 모든 조합을 보존하고 이후 데이터는 결과가 확정된 뒤에만 평가에 배정하세요.
비용이 결과를 크게 바꾸므로 낮은 회전율 설계는 합리적인 새 가설이지만, 별도의 이후 검증을 거쳐야 합니다. 2024~2025년을 다시 써 다른 기준이나 보유 기간을 고르면 그 날짜는 개발 데이터가 됩니다. 한 시장, 외부 미검증인 이전 데이터, 의존적인 결과, 이상화한 체결, 실거래 없음이 연구의 한계입니다. 미래 정보 참조 검사를 통과해야 백테스트를 해석할 수 있지만 수익성은 별도의 증거가 필요합니다.
머신러닝 매매 백테스트 검토 목록
- 실제 예측 한 건의 관측·학습·판단·체결 시각을 정확히 확인한다.
- 모든 학습 타깃이 적합 전에 확정되었음을 보이고, 특징 날짜 순서만 믿지 않는다.
- 이용 가능한 학습 행으로 변환을 적합하고 특징 순서와 월별 모델 상태를 보존한다.
- 기간 말 미확정 라벨은 결측으로 두고, 예측 평가와 실제 실행된 거래를 구분한다.
- 미래 변형에도 이전 출력이 유지되게 하고, 알려진 누출 대조 구현이 실패하는지 확인한다.
- 가격에 포함된 슬리피지와 미청산 시가평가를 포함해 체결 비용과 현금을 대조한다.
- 시도한 모든 설정, 불리한 기간, 적절한 기준선과 현실적인 비용 민감도를 보고한다.
- 판단에 사용할 증거를 관측하기 전에 다음 전향적 절차를 고정한다.
머신러닝 백테스트의 실무 질문
시간순 학습·테스트 분할로 미래 정보 참조 편향을 막을 수 있나요?
미래에서 과거로 섞이는 일부 문제는 막지만 충분하지 않습니다. 경계 이전의 학습 행도 그 이후에 끝나는 결과를 가질 수 있습니다. 이번 5일 타깃은 적합 때마다 미확정 행 다섯 개를 제외해야 합니다. 전처리, 특징 이용 가능 시점, 주문 시점도 따로 확인해야 합니다.
모든 특징을 하루씩 이동해야 하나요?
아닙니다. 필요한 이동은 시점에 따라 정해집니다. 오늘 확정 종가와 총거래량은 오늘 종가 이후 신호와 나중 체결에 사용할 수 있지만, 오늘의 이전 시가 주문에는 쓸 수 없습니다. 모든 입력을 무조건 이동하면 다른 누출을 해결하지 못한 채 의도한 전략이 바뀔 수 있습니다.
평가 기간 관측을 이후 월별 학습에 넣어도 되나요?
갱신 절차를 미리 고정했고 적합 시점에 관측의 타깃이 확정되었다면 가능합니다. 운용 모델이 새로 이용 가능해진 이력에서 학습하는 상황을 모사합니다. 평가 결과를 살펴본 뒤 하이퍼파라미터를 바꾸는 것은 다른 선택이며 새로운 평가 증거가 필요합니다.
예측 확률이 0.55를 넘으면 거래 기대이익이 양수인가요?
아닙니다. 라벨은 비용 전 5일 시가 간 수익률이 양수인지를 나타냅니다. 순기대값은 손익 크기, 비용, 자본, 체결에도 달려 있습니다. 모델 확률을 별도로 보정하지 않았으며, 올바른 전략은 가정한 비용 후 손실이었습니다.
매매 라벨에 TimeSeriesSplit의 gap을 얼마나 둬야 하나요?
실제 라벨 이용 가능 시점에서 도출해야 합니다. 이번 완전한 일별 데이터에서 종가 t에 판단하면 최신 학습 특징은 t−6이며, 첫 테스트 특징 t 앞에 다섯 행의 gap을 두는 것과 같습니다. 타깃, 거래일 달력, 보고 지연이 다르면 다른 gap이나 명시적 시각 필터가 필요할 수 있습니다.
ChatGPT나 Claude가 머신러닝 매매 봇의 수익성을 검증할 수 있나요?
실험을 명세하고 코드를 살피며 기록한 출력을 설명하는 데 도움을 줄 수 있습니다. 수익성은 올바른 시점의 관측에 대한 실행 가능한 계산과 그 이후 현실적인 조건의 증거로 확인해야 합니다. 이 연구는 Codex의 도움을 받아 고정 전략의 불리한 결과를 얻었으며, AI 간 투자 능력이나 실거래를 비교 검증하지 않았습니다.
출처와 연구 기록
수익률, 모델 출력, 계좌 사례는 TensorParadigm이 실행한 계산입니다. 저장소 연구 기록에는 성과 계산 전 프로토콜, 설정, 출처를 표시한 정규화 데이터, 실행 가능한 Python 구현, 테스트, 모든 모델 적합 상태와 전체 원장을 보존합니다. 아래 일차 자료는 방법·데이터·도구 설명을 뒷받침하지만 전략을 추천하지는 않습니다. scikit-learn은 계산에 사용한 1.6.1 환경에 대응하는 1.6 문서를 참조합니다.
- Scikit-learn 1.6: 흔한 문제, 학습 데이터만 쓰는 변환과 데이터 누출
- Scikit-learn 1.6: TimeSeriesSplit과 표본 수 기준 gap
- Scikit-learn 1.6: LogisticRegression 설정과 확률의 클래스 순서
- Scikit-learn 1.6: 분류 및 확률 예측 평가 지표
- humblefool06: BTC-USDT 4시간봉 아카이브, 고정한 공개 리비전과 라이선스 선언
- Binance 현물 API: 캔들 시각과 시장 데이터 엔드포인트
- Bailey 외: 백테스트 과최적화의 확률
- Politis·White: 의존성 부트스트랩의 자동 블록 길이 선택, 원형 재표집 포함
- OpenAI: 코드 생성과 Codex 개발 지침
- Anthropic: Claude Code 개요
변동비와 이상화한 체결을 사용한 교육용 과거 데이터 연구입니다. 실거래, 독립 전문가 검토, AI 간 투자 비교 실험은 수행하지 않았습니다. 과거 및 재표집 결과가 미래 수익성을 입증하지는 않습니다.