Como fazer backtest de estratégias de trading com aprendizado de máquina em Python sem viés de antecipação
Um backtest de ML executado em Python: alvos já observados, treinamento mensal, testes de causalidade, contabilidade das operações e prejuízo após custos. Seis atributos, sem entradas futuras.
Faça o backtest de uma estratégia com aprendizado de máquina reconstruindo o que estava disponível em cada decisão: atributos completos, alvos de treinamento já conhecidos, pré-processamento ajustado apenas no treino e ordens executadas após o sinal. Executamos esse procedimento para uma estratégia diária de Bitcoin com regressão logística. Em 2024–25, ela rendeu −1.67% após os custos modelados, contra +96.28% do referencial de comprar e manter com alocação inicial. Uma versão deliberadamente inválida, que consumia retornos futuros, pareceu render +867.06%. A diferença mostra por que é preciso testar o calendário de disponibilidade da informação antes de interpretar a rentabilidade.
O QUE ESTA INVESTIGAÇÃO ESTABELECE
- Uma divisão cronológica ainda pode vazar informação: cinco linhas de treinamento em cada fronteira mensal tinham alvos ainda não concluídos.
- Um novo padronizador e um novo modelo foram ajustados mensalmente em linhas passadas elegíveis; alvos anteriores da avaliação só entraram em ajustes posteriores depois de observáveis.
- Alterar observações futuras manteve idênticas as previsões e ordens anteriores da implementação válida, enquanto o controle inválido falhou.
- A estratégia fixa rendeu +17.51% sem taxas nem slippage e depois perdeu −1.67% após custos, em 66 operações concluídas.
- As métricas de previsão, uma operação perdedora, nove variantes de desenvolvimento e trajetórias de bootstrap condicional explicam por que o resultado não justifica capital real.
Comece por um horário e pergunte se a previsão era possível
Nosso guia anterior sobre viés de antecipação explica falhas comuns. Esta investigação constrói e executa um pipeline de ML efetivamente ajustado e acompanha suas previsões em uma conta de caixa. A pergunta é específica: seis atributos completos de preços e volume diários ajudam um modelo simples a escolher operações de Bitcoin de cinco dias lucrativas após custos?
A primeira verificação útil é um exemplo concreto de aceitação. No fechamento confirmado de 1º de janeiro de 2024, a data mais recente de atributo elegível para treino é 26 de dezembro de 2023. Seu resultado vai da abertura de 27 de dezembro à abertura de 1º de janeiro e, portanto, já é conhecido. A linha de atributos de 27 de dezembro precisa da abertura de 2 de janeiro e deve ser excluída. Nosso ajuste executado contém 725 linhas, termina em 26 de dezembro e prevê 0.452770 para os atributos de 1º de janeiro: abaixo do limiar fixo de negociação de 0.55.
Se uma suposta reprodução treina até 31 de dezembro, investigue o filtro de término do alvo antes de comparar lucros. Se a probabilidade for diferente, compare a entrada diária em UTC, a ordem dos atributos, as estatísticas do padronizador e as versões dos pacotes. Isso oferece um ponto de diagnóstico logo no início, em vez de pedir confiança em uma curva final atraente. A implementação completa, o protocolo, a entrada com atribuição, os registros de ajuste e o livro de operações estão preservados nos registros de pesquisa do repositório.
Congele a hipótese e as regras da conta antes de medir retornos
A hipótese econômica é deliberadamente modesta: retornos recentes, volatilidade, amplitude e atividade relativa podem conter informação suficiente sobre os próximos cinco dias entre aberturas para compensar custos repetidos de entrada e saída. Uma regressão logística é transparente o bastante para examinar coeficiente por coeficiente. A hipótese é plausível para teste; não é evidência de vantagem.
Registramos o protocolo e a configuração antes de calcular o desempenho deste estudo. C = 1 e o limiar de 0.55 foram fixados, não escolhidos pelo melhor resultado. A grade limitada de desenvolvimento é divulgada adiante. Os preços de desenvolvimento e avaliação já haviam aparecido em projetos anteriores da TensorParadigm; portanto, esta é uma demonstração retrospectiva de método, não uma amostra de descoberta intocada.
| Decisão | Especificação fixa |
|---|---|
| Mercado e relógio | BTCUSDT; diário em UTC; conta de caixa comprada/zerada, semelhante ao mercado à vista |
| Previsão | No fechamento confirmado t; probabilidade de open[t+6] / open[t+1] − 1 > 0 |
| Treinamento | Mensal; 730 dias corridos anteriores; apenas alvos conhecidos; pelo menos 252 linhas completas e ambas as classes |
| Modelo | StandardScaler → LogisticRegression; C = 1, lbfgs, max_iter = 2000 |
| Entrada e saída | Sem posição, p ≥ 0.55: comprar na abertura t+1; vender na abertura t+6; sem sinal no dia da execução da saída |
| Tamanho da posição | 90% do caixa disponível incluindo a taxa de entrada; BTC fracionário; uma posição; sem alavancagem |
| Custos por lado | Taxa de 10 pontos-base; execução adversa de 5 pontos-base; sem dedução adicional de spread |
| Desenvolvimento | 2021; 365 candles diários; observações anteriores de 2020 fornecem treinamento inicial |
| Validação | 2022–23; 730 candles; também são reportadas divisões anuais iniciadas sem posição |
| Avaliação | 2024–25; 731 candles; procedimento e configurações do reajuste mensal congelados |
Cada período começa com 10,000 USDT e sem posição. Uma saída programada para cinco dias continua sendo uma saída mesmo quando a próxima previsão discorda. O último sinal de entrada permitido é determinado pelo calendário conhecido, para que toda operação da estratégia termine dentro do período reportado. As seis datas finais podem ter previsões, mas não podem iniciar operações nem contribuir com resultados ainda desconhecidos para as métricas de classificação do período.
Estabeleça o que os dados representam, incluindo o que permanece sem verificação
A entrada contém 2,142 candles diários completos de 20 de fevereiro de 2020 a 31 de dezembro de 2025. Reutilizamos o arquivo BTC-USDT de quatro horas de humblefool06 na revisão 9f491eb5340dd6a24f27fde24edf098e1e785443, cujo publicador declara CC BY 4.0. Cada candle diário combina seis observações UTC: primeira abertura, maior máxima, menor mínima, último fechamento e soma do volume do ativo-base. O dia incompleto anterior é excluído. O SHA-256 do CSV normalizado é 43655a51e6cb41c2ee087bd947f4cefb7dd4151617a29d7f75a3cda471ae5cbb. [5]
Uma conferência de 18 de outubro de 2026, preservada do estudo anterior, encontrou correspondência entre todos os 731 candles da avaliação, ou 3,655 células OHLCV, e o endpoint diário da Binance, usando comparação decimal. Herdamos esse registro com a mesma entrada; não fizemos uma nova auditoria independente para este artigo. O arquivo não identifica explicitamente a origem de negociação dos dados. A correspondência com a Binance demonstra concordância de preços, não cobertura de mercados independentes nem atribuição da fonte original. As observações de treino e validação de 2020–23 permanecem sem verificação externa. A Binance identifica candles pelo horário de abertura; uma data diária nas tabelas identifica a sessão UTC. [6]
O programa verifica datas únicas e crescentes, continuidade diária, OHLCV finitos, preços positivos e limites consistentes entre máximas e mínimas. Essas verificações detectam entradas malformadas, não toda observação incorreta. Um único instrumento cripto sobrevivente também nada diz sobre o desempenho de um universo historicamente disponível para investimento. Python 3.13.3, pandas 2.2.3, NumPy 2.2.6 e scikit-learn 1.6.1 produziram os cálculos reportados.
Use preços futuros para definir resultados, nunca como entrada de previsão
As seis entradas são retornos de fechamento de um, cinco e vinte dias; o desvio-padrão populacional dos últimos vinte retornos diários; a amplitude máxima–mínima do dia concluído dividida pelo fechamento; e o volume dividido por sua média móvel de vinte dias, menos um. Todas as janelas incluem a sessão recém-concluída. Descartamos as linhas incompletas do período inicial em vez de preenchê-las com dados posteriores. O fechamento atual é uma entrada válida para uma decisão após esse fechamento; não está disponível para uma decisão na abertura anterior do mesmo dia.
As expressões de atributos abaixo são trechos da implementação Python executada. Uma janela que olha apenas para trás é essencial. Substituí-la por uma janela centrada ou estimar uma transformação no histórico completo mudaria a informação disponível no momento da decisão. A orientação do scikit-learn sobre vazamento também exige aprender transformações no subconjunto de treinamento. [1]
returns = close.pct_change(fill_method=None)
X = pd.DataFrame({
    "return_1": returns,
    "return_5": close.pct_change(5, fill_method=None),
    "return_20": close.pct_change(20, fill_method=None),
    "volatility_20": returns.rolling(20).std(ddof=0),
    "range_to_close": (high - low) / close,
    "relative_volume_20": volume / volume.rolling(20).mean() - 1,
})
O alvo usa aberturas futuras porque descreve o resultado a prever. O rótulo 1 significa que a abertura bruta de saída supera a abertura bruta de entrada; a igualdade pertence à classe 0. Isso não significa que a operação lucrou após taxas. Os deslocamentos negativos abaixo pertencem apenas à construção do alvo. Os resultados finais ausentes continuam ausentes: aplicar apenas uma comparação transformaria silenciosamente resultados desconhecidos em observações falsas de classe 0.
target_return = open_price.shift(-6) / open_price.shift(-1) - 1
y = (target_return > 0).where(target_return.notna())
label_end = X.index + pd.Timedelta(days=6)

train_mask = (
    (X.index >= fit_date - pd.Timedelta(days=730))
    & (X.index < fit_date)
    & (label_end <= fit_date)
    & y.notna()
    & X.notna().all(axis=1)
)
Uma divisão por datas não basta quando os alvos de treino avançam para o futuro
No fechamento de 1º de janeiro de 2024, um filtro ingênuo dos 730 dias anteriores seleciona atributos de 1º de janeiro de 2022 a 31 de dezembro de 2023. Cinco linhas são inelegíveis: seus resultados terminam entre 2 e 6 de janeiro de 2024. A condição de maturidade as remove, deixando 725 observações até 26 de dezembro. A mesma exclusão de cinco linhas aparece em cada ajuste mensal no registro da avaliação.
O diagrama distingue um resultado já observado de outro que cruza a fronteira de decisão. Suas datas descrevem o protocolo real, não uma trajetória de preços inventada. Embora os dois lados da fronteira sejam chamados de janeiro no texto, a abertura de 1º de janeiro está disponível no fechamento desse dia; a abertura de 2 de janeiro ainda não.
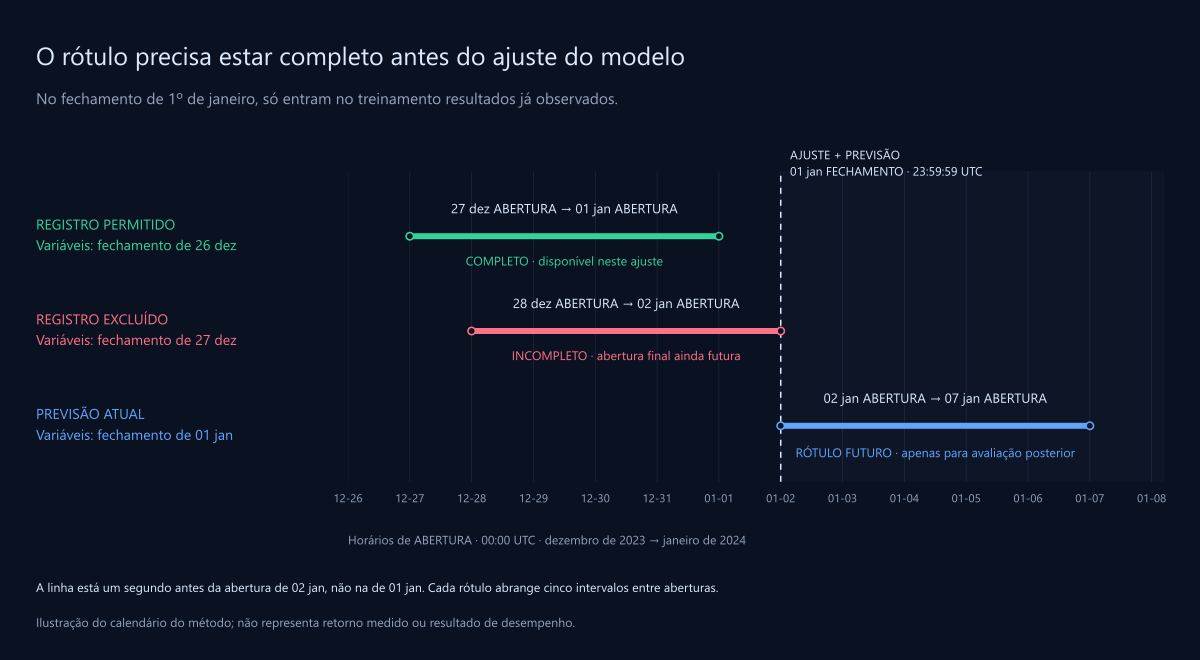
Para este calendário diário completo, um TimeSeriesSplit cujo primeiro atributo de teste tem data t precisaria de um gap de cinco amostras para deixar o último atributo de treino em t−6. Um gap de seis amostras seria conservador. O scikit-learn define gap em amostras, não em tempo corrido. Prazos de manutenção variáveis, sessões ausentes e atrasos de dados exigem os horários reais de disponibilidade, em vez de copiar esse inteiro. Usamos máscaras explícitas de término dos alvos, não TimeSeriesSplit, nos ajustes registrados. [2]
Este experimento de trading que avança no tempo precisa preservar a cronologia. Isso não é uma afirmação universal sobre todo uso de validação cruzada aleatória em estatística de séries temporais. Aqui, resultados adjacentes de cinco dias se sobrepõem, e uma linha datada antes do conjunto de teste ainda pode conter um alvo indisponível. Remover o vazamento na fronteira do treinamento tampouco torna os resultados restantes do teste estatisticamente independentes.
Ajuste o padronizador e o classificador na mesma janela de treinamento elegível
No primeiro dia de previsão de cada mês, criamos um novo pipeline, ajustamos apenas nas linhas passadas maduras e preservamos seu estado até o próximo ajuste mensal. Os atributos do dia são transformados com essas estatísticas já ajustadas; não entram no ajuste do padronizador. Um pipeline ajuda a impor essa fronteira, mas não corrige um atributo derivado do futuro nem um conjunto de treinamento selecionado incorretamente. [1]
pipeline = Pipeline([
    ("scale", StandardScaler()),
    ("model", LogisticRegression(
        C=1, solver="lbfgs", max_iter=2000, random_state=6142026
    )),
])
pipeline.fit(X.loc[train_mask], y.loc[train_mask].astype(int))
assert pipeline.named_steps["model"].classes_.tolist() == [0, 1]
p_up = pipeline.predict_proba(X.loc[[signal_date]])[0, 1]
C é o inverso da intensidade da regularização: um valor menor impõe regularização mais forte. A coluna da probabilidade positiva é conferida com classes_ = [0, 1]. Registramos a ordem dos atributos, o hash das linhas de treino, as médias e escalas do padronizador, os coeficientes, o intercepto e as iterações do otimizador. O solver é lbfgs; passar random_state não explica seu determinismo. [3]
O reajuste mensal pode usar legitimamente resultados anteriores da avaliação depois de maduros. Por exemplo, um ajuste de fevereiro pode aprender com observações elegíveis de janeiro. Trata-se de um procedimento fixo de atualização avaliado em ordem temporal, não de um único modelo congelado por dois anos. Nunca usamos resultados posteriores da avaliação para mudar C, o limiar, os atributos ou o calendário de ajustes. Alterar essas escolhas exigiria um novo protocolo de avaliação.
Reconstrua a primeira previsão aceita em vez de confiar em predict_proba
O primeiro sinal aceito na avaliação ocorre no fechamento de 12 de janeiro de 2024. Ele ainda usa o ajuste de 1º de janeiro: 725 linhas entre 1º de janeiro de 2022 e 26 de dezembro de 2023, com o último resultado de treino encerrado na abertura de 1º de janeiro. A tabela expõe o vetor real de atributos, seus valores padronizados com o treino e os coeficientes ajustados. Os valores exibidos estão arredondados; a auditoria usa precisão completa.
| Atributo | Valor bruto | z padronizado | Coeficiente |
|---|---|---|---|
| return_1 | −0.076748 | −2.672794 | −0.103549 |
| return_5 | −0.026094 | −0.417899 | −0.111867 |
| return_20 | −0.021039 | −0.200837 | +0.039253 |
| volatility_20 | 0.030521 | 0.420563 | +0.026111 |
| range_to_close | 0.117233 | 2.754973 | −0.019805 |
| relative_volume_20 | 0.778955 | 1.552860 | +0.037502 |
Para cada atributo, z = (x − média do treino) / escala do treino. O intercepto 0.014133035 mais a soma de z vezes o coeficiente resulta em um logit de 0.344416426. Aplicar 1 / (1 + exp(−logit)) produz 0.585262925. Isso supera 0.55, então uma conta sem posição envia uma compra para a abertura de 13 de janeiro. É uma probabilidade de movimento bruto positivo do preço segundo o modelo, não uma probabilidade calibrada de lucro líquido da operação.
A probabilidade do primeiro dia de avaliação, 0.452769888, corretamente não produz operação. Esses dois pontos de auditoria ajudam a distinguir divergências nos atributos ou no ajuste de divergências no tratamento das ordens. Uma previsão correta ainda pode virar um backtest incorreto se a execução, o dimensionamento pelo caixa ou o relógio de saída estiverem errados.
Separe a previsão, a ordem e a conta de caixa
Um sinal de fechamento elegível programa uma entrada na próxima abertura e uma saída cinco intervalos entre aberturas depois. A simulação aloca caixa na execução efetiva: quantidade = 0.90 × caixa / (preço de compra × 1.001). Isso descreve a alocação por caixa no lado da execução, não uma quantidade calculada ontem usando a abertura desconhecida de amanhã. A compra ocorre na abertura bruta × 1.0005; a venda, na abertura bruta × 0.9995. Cada taxa é 0.001 vezes o valor financeiro executado com slippage.
if flat and not exited_today and p_up >= 0.55:
    entry_date = signal_date + pd.Timedelta(days=1)
    exit_date = signal_date + pd.Timedelta(days=6)
    if exit_date <= evaluation_end:  # known calendar, not future prices
        pending_buy = (entry_date, exit_date)

# At the entry open:
fill = open_price * 1.0005
quantity = 0.90 * cash / (fill * 1.001)
Em cada fechamento diário, o patrimônio é o caixa mais a quantidade de BTC vezes o fechamento bruto. O drawdown é medido a partir do pico acumulado dessa conta diária, incluindo o saldo inicial. O slippage já está embutido nos preços e não é deduzido de novo. Todas as posições da estratégia terminam dentro da janela reportada; comprar e manter, por outro lado, conserva BTC no fechamento final, com a taxa de entrada contabilizada e sem taxa fictícia de saída.
No mercado cripto, o fechamento diário e a abertura seguinte são adjacentes. Executar exatamente nessa abertura é uma hipótese idealizada: o estudo não demonstra latência viável de cálculo do modelo, corretora ou rede. Cinco pontos-base são uma hipótese de sensibilidade, não uma medição observada do livro de ofertas. Excluímos alavancagem, posições vendidas, stops, funding, juros do caixa, impostos, despesas fixas e conversão de USDT; quantidades fracionárias ignoram os filtros da plataforma. Essas escolhas definem o escopo da simulação.
O modelo fixo perde após custos e fica atrás do simples referencial de manutenção
Os resultados brutos vêm de uma execução separada da conta com taxas e slippage iguais a zero. Os resultados líquidos usam as hipóteses fixas de dez mais cinco pontos-base por lado. As contas de desenvolvimento, validação e avaliação começam, cada uma, com 10,000 USDT. A tabela apresenta resultados medidos, não expectativas ajustadas.
| Período | Retorno bruto do ML | Retorno líquido do ML | Drawdown máximo do ML | Operações encerradas | Comprar e manter líquido |
|---|---|---|---|---|---|
| Desenvolvimento 2021 | +26.88% | +10.56% | 41.81% | 51 | +53.60% |
| Validação 2022–23 | −40.06% | −46.76% | 54.13% | 44 | −7.78% |
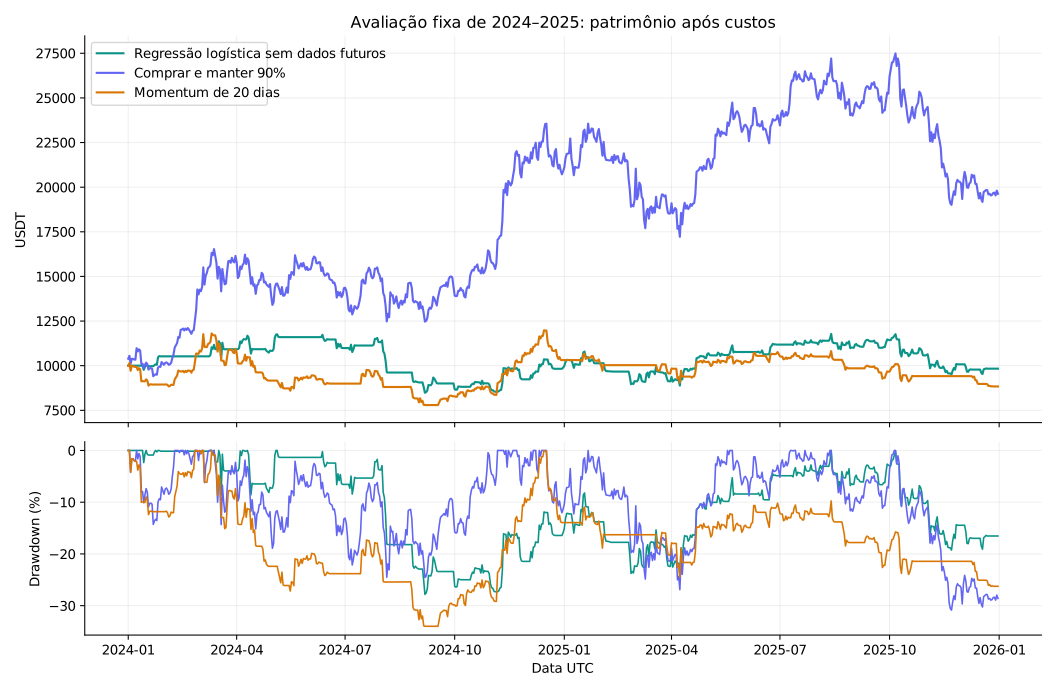
| Avaliação 2024–25 | +17.51% | −1.67% | 27.82% | 66 | +96.28% |
Na avaliação, a conta de ML termina com 9,832.51 USDT, sem BTC aberto e com −167.49 USDT de resultado de operações concluídas. Seu drawdown máximo diário de 27.82% é apenas moderadamente inferior aos 30.86% de comprar e manter, apesar da exposição média investida de 40.63%. Ela mantém BTC em 330 de 731 fechamentos diários. Menor exposição não implica automaticamente uma alternativa atraente após ajuste por risco.
Dois referenciais de decisão usam as mesmas regras de manutenção por cinco dias, intervalo sem novas entradas, dimensionamento e custos. Comprar quando o retorno concluído de vinte dias é positivo rende −11.63% em 71 operações, com drawdown de 33.99%. Negociar quando a frequência de alvos positivos na amostra mensal madura de treino atinge 0.55 rende −26.56% em 36 operações, com drawdown de 37.85%. A regra de ML supera essas duas políticas aqui, mas perde dinheiro e fica muito atrás de comprar e manter. Isso não basta para demonstrar uma vantagem econômica duradoura dos atributos.
As contas desenhadas usam o patrimônio diário efetivamente calculado. Comprar e manter investe 90% na primeira abertura de cada período, com os mesmos custos de entrada, e deixa 10% em caixa. Sua exposição muito maior ao mercado faz parte da comparação, não é uma estimativa controlada da contribuição causal do ML. Para uma interpretação mais ampla, veja nossa investigação sobre ML e trading baseado em regras.
Acurácia de previsão e rentabilidade das operações são medições diferentes
Avaliamos 725 previsões com resultado inteiramente observado na avaliação, incluindo previsões feitas enquanto a conta já mantém BTC. Os seis resultados restantes vão além do período e são excluídos. Há 390 rótulos positivos, ou 53.79%. O referencial de frequência prevê a proporção positiva do treino maduro de cada mês, sem usar os seis atributos.
A acurácia usa um corte de classificação de 0.50; as ordens usam 0.55. O escore de Brier mede o erro quadrático das probabilidades, a perda logarítmica penaliza erros de probabilidade de forma logarítmica e a ROC AUC mede a ordenação. Seus valores não incorporam tamanho de posição nem taxas. Um Brier menor, sozinho, também não demonstra melhor calibração: ele reflete mais do que calibração. Nossas probabilidades não foram calibradas separadamente. [4]
| Previsão na avaliação | Acurácia com corte 0.50 | Brier ↓ | Perda logarítmica ↓ | ROC AUC |
|---|---|---|---|---|
| Regressão logística com seis atributos | 50.76% | 0.251416 | 0.695919 | 0.502044 |
| Referencial da frequência no treino maduro | 53.79% | 0.249933 | 0.693033 | 0.476881 |
O modelo de ML não melhora o Brier nem a perda logarítmica do referencial de frequência. Sua AUC de 0.5020 está perto de 0.5, mas não atribuímos a esses resultados sobrepostos uma alegação de significância baseada em observações independentes. Tampouco 725 previsões equivalem a 725 operações independentes: a conta encerra efetivamente 66 operações. As pequenas diferenças nas métricas não oferecem um argumento preditivo convincente contra o resultado econômico.
Acompanhe a primeira operação perdedora pelas duas execuções e pelo saldo
A previsão de 0.585262925 de 12 de janeiro aciona a primeira operação. Em 13 de janeiro, a abertura bruta de entrada é 42,782.74 USDT. Após cinco pontos-base de execução adversa, a compra ocorre a 42,804.131370. A quantidade é 0.210050027959 BTC. O valor financeiro de entrada é 8,991.008991 USDT e a taxa é 8.991009, deixando exatamente 1,000 USDT em caixa.
A saída obrigatória de 18 de janeiro usa a abertura bruta de 42,776.09 e uma venda a 42,754.701955. Sua taxa é 8.980626 USDT. O resultado de preço entre as execuções com slippage é −10.382650; subtrair as duas taxas resulta em −28.354285 USDT. O caixa final é 9,971.645715. Isso reconcilia os 10,000 iniciais com uma posição zerada; a probabilidade do modelo não substituiu a saída programada.
Nas 66 operações de avaliação, 32 ganham e 34 perdem após custos: uma taxa de acerto de 48.48%. O ganho médio é +332.83 USDT e a perda média −318.18, uma relação ganho/perda de cerca de 1.05. A média por operação é −2.54 USDT e o fator de lucro é 0.9845. Nem a taxa de acerto nem a previsão bruta de direção explicam sozinhas o resultado em caixa; taxas, preços executados, capital variável e magnitude dos ganhos e perdas também importam.
Faça um modelo com vazamento falhar em um teste, mesmo que seus retornos pareçam excelentes
Alteramos todas as observações após 15 de junho de 2024: os preços OHLC dobraram e o volume triplicou, enquanto os valores anteriores permaneceram iguais. Reconstruir o modelo válido deixou inalterados os atributos passados, as matrizes de treinamento elegíveis, o estado do padronizador e do modelo, as previsões, decisões e execuções. A diferença máxima nas probabilidades anteriores foi exatamente zero. É um teste de invariância executado para esta implementação; não prova que todo viés possível foi eliminado.
changed = bars.copy()
future = changed.index > cutoff
changed.loc[future, ["open", "high", "low", "close"]] *= 2
changed.loc[future, "volume"] *= 3
# Valid: past features, fit states, predictions and orders are identical.
# INVALID control: X also contains target_return, so this check fails.
O controle negativo acrescenta deliberadamente o retorno futuro realizado entre aberturas como sétima entrada. Mantém o mesmo pipeline mensal e as regras da conta, mas viola a disponibilidade da informação no momento da previsão. Reporta um retorno líquido aparente de +867.06%, acurácia de classificação de 97.66% e AUC de 0.998676. São medições de um backtest INVÁLIDO, não uma estratégia candidata nem um resultado usado na seleção.
A mesma alteração futura muda as probabilidades anteriores do modelo inválido em até 0.998626629. O controle demonstra que um padronizador correto, ajustes cronológicos e contabilidade plausível não salvam uma entrada indisponível. Em comparação, os cinco alvos imaturos da fronteira são um erro menos evidente: o calendário demonstra sua invalidade sem exigir uma mudança de desempenho chamativa.
Os testes da pesquisa também cobrem a temporalidade dos atributos retrospectivos, alvos finais ausentes, fronteiras exatas de maturidade, padronização apenas no treino, reutilização do ajuste mensal, limites do período de classificação, ordens sem sobreposição, bloqueio no dia da saída, dimensionamento com taxas, reconciliação de caixa e resultado e reamostragem determinística em blocos. Um teste de causalidade deve falhar em uma versão sabidamente defeituosa; observar que o código roda é evidência fraca.
Divulgue a grade de desenvolvimento e preserve as divisões de validação desfavoráveis
Avaliamos apenas nove combinações no desenvolvimento: C em {0.1, 1, 10} e limiar de entrada em {0.50, 0.55, 0.60}. A tabela mostra os retornos líquidos de 2021. Todas as variantes são preservadas, inclusive as que perdem atratividade quando o limiar muda. A configuração predefinida de C = 1 e limiar = 0.55 permanece a estratégia do artigo, mesmo que outras configurações pareçam melhores no desenvolvimento.
| C | Limiar 0.50 | Limiar 0.55 | Limiar 0.60 |
|---|---|---|---|
| 0.1 | +7.81% | +10.56% | +25.24% |
| 1 | +7.81% | +10.56% | +55.01% |
| 10 | +7.81% | +10.56% | +55.01% |
Nos limiares 0.50 e 0.55, os três valores de C produzem o mesmo percurso de operações executadas; isso não significa probabilidades idênticas. Em 0.60, o percurso de C = 0.1 difere. Mudar o limiar altera a elegibilidade das operações e as oportunidades posteriores após o intervalo sem entradas, explicando por que pequenas diferenças de previsão podem mudar retornos compostos. Essa grade não identifica uma região estável de lucro entre períodos de mercado.
A validação usa o procedimento fixo, com ajustes mensais móveis. Contas anuais separadas perdem −44.04% em 2022, em 37 operações, e −4.87% em 2023, em sete operações. Seus drawdowns máximos são 54.13% e 8.60%. São divisões iniciadas sem posição, com suas próprias exclusões finais pelo calendário; por isso, compor esses retornos não equivale exatamente à conta contínua de 2022–23. Na conta contínua de avaliação, 2024 rende −1.14% e 2025, −0.54%.
Selecionar a melhor variante histórica cria um procedimento de pesquisa diferente de avaliar uma regra fixa. Bailey e colaboradores formalizam como a seleção entre backtests pode levar a sobreajuste. Divulgamos essa pequena grade e as divisões desfavoráveis; não alegamos estimar uma probabilidade formal de sobreajuste do backtest com nove configurações. Mudar a configuração após este relatório transformaria esses períodos em evidência de desenvolvimento. [7]
O giro consome o ganho bruto, e poucas operações têm grande peso
A conta de avaliação realiza 132 execuções. O valor financeiro somado das compras e vendas equivale a 122.29 vezes o patrimônio inicial; esta definição de giro de uma via inclui ambos os lados e não representa 122 ciclos completos de todo o capital. As taxas somam 1,222.92 USDT. A perda de execução embutida em relação às aberturas brutas soma 611.46 USDT. Mudar os custos também muda as quantidades posteriores; portanto, subtrair esses totais do livro da conta bruta separada não reconstrói exatamente o resultado líquido.
A tabela de sensibilidade muda apenas o slippage adverso, mantendo a taxa de dez pontos-base por lado e as mesmas decisões do modelo. Mesmo com slippage zero, o retorno é apenas +4.34%; com dez pontos-base, é −7.34%. O estudo, portanto, não estabelece uma margem confortável de execução. O resultado sem taxas nem slippage de +17.51% ajuda a entender a contabilidade, mas não é uma previsão realizável de retornos líquidos.
| Taxa por lado | Slippage por lado | Retorno líquido na avaliação | Drawdown máximo |
|---|---|---|---|
| 10 pb | 0 pb | +4.34% | 27.37% |
| 10 pb | 5 pb | −1.67% | 27.82% |
| 10 pb | 10 pb | −7.34% | 28.27% |
| 10 pb | 20 pb | −17.72% | 30.67% |
As três maiores operações ganhadoras líquidas contribuem com +2,764.12 USDT. Todas as demais operações concluídas somam −2,931.61. É um cálculo descritivo de concentração usando o livro observado, não uma nova execução que elimina essas operações e altera o caixa posterior. Uma melhoria proposta deve explicar como preservaria os ganhos ou reduziria o giro com informações disponíveis de antemão; apagar perdedoras históricas apenas criaria outro resultado enviesado.
Reamostre trajetórias da conta sem fingir que produz novas evidências
Geramos 5,000 trajetórias condicionais sorteando blocos circulares de vinte retornos diários líquidos consecutivos da conta, incluindo dias sem posição, até cada trajetória conter 731 dias. A semente 6142026 fixa o cálculo. Voltar ao início no fim da amostra e manter blocos consecutivos preserva parte da dependência local, usando a construção de reamostragem circular descrita por Politis e White. Nosso bloco tem tamanho fixo de vinte dias; não usamos o método automático de seleção dos autores. Essa escolha não garante capturar toda a dependência relevante nem que o processo de retornos seja estacionário. [8]
O quinto percentil, a mediana e o nonagésimo quinto percentil do retorno final são −42.11%, −1.03% e +61.61%. Para o drawdown máximo, são 16.79%, 30.26% e 51.19%. Das trajetórias reamostradas, 51.44% terminam abaixo do patrimônio inicial. Essa fração é condicional à amostra histórica e à regra de reamostragem; não é uma estimativa da probabilidade real de a estratégia perder dinheiro.
Este bootstrap rearranja a série realizada de retornos da conta. Não gera novos preços, não reajusta o modelo nem recalcula ordens, e as sequências sorteadas podem não representar históricos viáveis de negociação. Ele explora a sensibilidade à trajetória, condicionada ao que ocorreu. Mais trajetórias reduzem o ruído de simulação, mas não acrescentam observações de mercado, operações independentes nem evidência de vantagem preditiva.
Dê ao colaborador de IA condições de aceitação que ele possa verificar
ChatGPT ou Claude podem ajudar a transformar uma ideia de trading em uma especificação precisa e questionar ambiguidades. Codex ou Claude Code podem trabalhar com arquivos do repositório, executar cálculos e examinar falhas. A documentação oficial dos produtos sustenta esses papéis de desenvolvimento; nenhuma dessas capacidades demonstra vantagem de negociação. Este projeto usou assistência do Codex e cálculos locais em Python. Não fizemos uma comparação controlada entre ChatGPT e Claude, não usamos um LLM para gerar previsões de mercado nem obtivemos revisão de especialistas independentes. [9] [10]
Os prompts abaixo tornam quatro tarefas diferentes verificáveis. Forneça a especificação congelada e o código relevante em cada solicitação. Os dados de mercado fornecem observações, programas executáveis calculam resultados e o pesquisador decide se hipóteses e evidências justificam um novo teste. Uma narrativa confiante não substitui um livro reconciliado. Para o processo de desenvolvimento mais amplo, veja construção e teste de um algoritmo de trading.
Especifique um experimento diário UTC de BTCUSDT com ML, comprado/zerado. No fechamento confirmado t, preveja o sinal de open[t+6]/open[t+1]-1. Defina a disponibilidade de cada atributo, a maturidade do alvo, a janela de treinamento mensal, o calendário de entrada/saída, o dimensionamento pelo caixa e os custos. Separe reajuste de seleção de hiperparâmetros. Liste ambiguidades e informe a data mais recente de atributo elegível para treino no fechamento de 2024-01-01. Não calcule desempenho nem escolha configurações pelos retornos.Implemente a especificação congelada em anexo com funções separadas para atributos/alvos, ajuste mensal e conta de caixa. Ajuste StandardScaler apenas dentro do trecho de treinamento com alvos maduros. Preserve os alvos finais ausentes. Registre datas elegíveis, ordem dos atributos, estado do padronizador, coeficientes, probabilidades, decisões e execuções. Não reajuste C=1 nem threshold=0.55. Acrescente um teste no qual mudanças no OHLCV futuro deixem idênticas todas as previsões e ordens válidas anteriores; mostre que acrescentar intencionalmente o atributo target_return faz o teste falhar.Audite o sinal de 2024-01-12 sem mudar a estratégia. Reconstrua os atributos padronizados, o logit e a probabilidade a partir do ajuste de 2024-01-01. Acompanhe a entrada de 13 de janeiro e a saída de 18 de janeiro com taxas de dez pontos-base e execuções adversas de cinco pontos-base. Mostre quantidade, caixa, as duas taxas e o resultado líquido. Reconcilie o patrimônio final com o caixa inicial mais o resultado encerrado e o resultado aberto marcado a mercado. Identifique o primeiro registro divergente, em vez de explicar apenas o retorno final.Escreva um relatório de pesquisa a partir das saídas registradas. Inclua todas as variantes de desenvolvimento, períodos cronológicos, retornos brutos/líquidos, referenciais, métricas de previsão, drawdown, exposição, giro, assimetria dos ganhos e perdas, custos e concentração. Explique alvos sobrepostos e os limites do bootstrap condicional em blocos. Marque o controle com atributo futuro como INVÁLIDO onde quer que seja reportado. Diferencie cálculos executados, trechos ilustrativos e componentes não executados. Divulgue a familiaridade prévia com os preços e os limites da verificação de dados. Não otimize para obter uma manchete de lucro.Para este pipeline móvel do scikit-learn, não fornecemos nem executamos uma implementação equivalente em Pine. Copiar os coeficientes de apenas um mês ajustado congelaria uma estratégia diferente; uma comparação fiel precisa reproduzir a janela de treinamento, a padronização, a maturidade dos alvos, os reajustes e a semântica de execução. É um limite de escopo da investigação, não uma afirmação de que Pine não possa expressar cálculos de aprendizado de máquina. Nosso estudo de backtest Python–Pine explica por que reproduzir apenas a fórmula do sinal não basta.
O próximo passo justificado é um teste prospectivo registrado, não a implantação
A implementação passa nas propriedades causais que testamos, mas a estratégia fixa perde após custos, não melhora as principais métricas de probabilidade e sofre um drawdown severo na validação. Esses achados não justificam capital real. O resultado útil do artigo é um método para distinguir uma medição histórica válida de um vazamento de informação com aparência lucrativa.
Se a pesquisa continuar, registre um novo intervalo prospectivo de simulação antes que ele comece. Congele os atributos, a regra de maturidade, o calendário de reajustes, os custos e os critérios de relatório. Registre os horários de cada entrada concluída, estado ajustado, sinal e próxima execução viável; meça o atraso real e o spread cotado. Compare com a previsão de frequência do treino e com a simples conta de manutenção. Preserve toda variante proposta e só atribua dados posteriores à avaliação depois que seus resultados amadurecerem.
Uma arquitetura com menor giro é uma nova hipótese razoável, porque os custos mudam materialmente este resultado, mas precisa merecer aprovação em seu próprio teste posterior. Reutilizar 2024–25 para escolher outro limiar ou prazo de manutenção transforma essas datas em dados de desenvolvimento. Um único mercado, dados anteriores sem verificação externa, resultados dependentes, execuções idealizadas e ausência de operações ao vivo limitam o que esta investigação pode estabelecer. Passar em um teste de antecipação é necessário para interpretar um backtest; a rentabilidade ainda exige evidência separada.
Uma lista de revisão para backtests de trading com ML
- Para uma previsão real, identifique os horários exatos da observação, do ajuste, da decisão e da execução.
- Mostre que cada alvo de treinamento já estava conhecido antes do ajuste; não confie apenas na ordem das datas dos atributos.
- Ajuste as transformações nas linhas de treinamento elegíveis, preserve a ordem dos atributos e retenha o estado de cada modelo mensal.
- Mantenha ausentes os alvos finais ainda desconhecidos e diferencie as métricas das previsões das operações executadas.
- Faça as alterações futuras preservarem as saídas anteriores e verifique que um controle com vazamento conhecido falha.
- Reconcilie os custos das duas execuções e o caixa, incluindo posições abertas marcadas a mercado e slippage já embutido nos preços.
- Reporte todas as configurações tentadas, períodos desfavoráveis, referenciais adequados e sensibilidade a custos realistas.
- Congele o próximo procedimento prospectivo antes de observar a evidência que o avaliará.
Dúvidas práticas sobre backtests com ML
Uma divisão cronológica entre treino e teste evita viés de antecipação?
Ela evita parte da mistura do futuro com o passado, mas não basta. Uma linha de treinamento anterior à fronteira pode ter um resultado que só termina depois dela. Nosso alvo de cinco dias exige excluir cinco linhas ainda não maduras em cada ajuste. Pré-processamento, disponibilidade dos atributos e horários das ordens também precisam de verificações separadas.
Todo atributo deve ser deslocado em um dia?
Não. O momento de uso determina o deslocamento necessário. O fechamento confirmado e o volume total de hoje podem sustentar um sinal após o fechamento para uma execução posterior. Não podem sustentar uma ordem na abertura anterior do mesmo dia. Deslocar todas as entradas indiscriminadamente pode mudar a estratégia pretendida sem resolver outros vazamentos.
Uma observação do período de avaliação pode entrar no treinamento de um mês posterior?
Sim, se o procedimento de atualização foi fixado antes e o alvo da observação já estiver maduro naquele ajuste. Isso simula um modelo operacional aprendendo com histórico recém-disponível. Mudar hiperparâmetros depois de examinar os resultados da avaliação é outra decisão de seleção e exige nova evidência de avaliação.
Uma probabilidade prevista acima de 0.55 significa lucro esperado positivo na operação?
Não. Nosso rótulo descreve um retorno bruto positivo entre aberturas ao longo de cinco dias. A expectativa líquida também depende dos ganhos e perdas, custos, capital e execução. As probabilidades do modelo não passaram por calibração separada, e a estratégia válida perdeu após os custos modelados.
Qual gap o TimeSeriesSplit deve usar para alvos de trading?
Derive-o da disponibilidade real dos alvos. Para nossos dados diários completos e uma decisão no fechamento t, o atributo de treinamento mais recente é t−6, equivalente a um intervalo de cinco linhas antes do primeiro atributo de teste t. Outros alvos, calendários de sessões e atrasos de divulgação podem exigir outro gap ou filtragem explícita por horário.
ChatGPT ou Claude podem validar se um bot de trading com ML é lucrativo?
Podem ajudar a especificar o experimento, examinar o código e explicar as saídas registradas. A rentabilidade deve vir de cálculos executáveis sobre observações com temporalidade correta, seguidos por mais evidências em condições realistas. Este estudo usou assistência do Codex, encontrou um resultado fixo desfavorável e não testou habilidade comparativa de investimento das IAs nem trading ao vivo.
Fontes e registros da pesquisa
Retornos, saídas dos modelos e exemplos de contas são cálculos executados pela TensorParadigm. Os registros no repositório preservam o protocolo anterior ao cálculo do desempenho, a configuração, os dados normalizados com atribuição, a implementação Python executável, os testes, todos os ajustes dos modelos e os livros completos de operações. As fontes primárias abaixo sustentam as descrições dos métodos, dados e ferramentas; não endossam a estratégia. As referências do scikit-learn usam a documentação 1.6, correspondente ao ambiente 1.6.1 executado.
- Scikit-learn 1.6: armadilhas comuns, transformações ajustadas apenas no treino e vazamento de dados
- Scikit-learn 1.6: TimeSeriesSplit e seu gap contado em amostras
- Scikit-learn 1.6: configuração do LogisticRegression e ordem das classes nas probabilidades
- Scikit-learn 1.6: métricas de classificação e de qualidade das probabilidades
- humblefool06: arquivo BTC-USDT de quatro horas, revisão fixa do publicador e declaração de licença
- Binance Spot API: horários dos candles e endpoint de dados de mercado
- Bailey e colaboradores: A probabilidade de sobreajuste do backtest
- Politis e White: Seleção automática do tamanho de blocos para o bootstrap dependente, incluindo reamostragem circular
- OpenAI: orientações para geração de código e desenvolvimento com Codex
- Anthropic: visão geral do Claude Code
Pesquisa retrospectiva educacional, com custos variáveis modelados e execuções idealizadas. Não houve trading ao vivo, revisão de especialistas independentes nem experimento comparativo de investimento com IA. Resultados históricos e reamostrados não demonstram rentabilidade futura.