如何用 Python 回测机器学习交易策略,并避免前视偏差
一次实际执行的 Python 机器学习回测:已成熟标签、每月训练、因果性检验、逐笔交易核算,以及扣除成本后的亏损结果。六个特征,不使用未来输入。
回测机器学习交易策略,首先要重建每次决策时实际可用的信息:已完成的特征、结果已经确定的训练标签、只在训练集上拟合的预处理,以及信号产生之后才成交的订单。我们为一套比特币日频逻辑回归策略实际执行了这一流程。2024–25 年,计入所设成本后,策略收益为 −1.67%,而期初一次配置的买入持有基准收益为 +96.28%。一个故意使用未来收益的无效版本,表面收益却达到 +867.06%。这种差异说明,解读盈利表现之前,必须先检验信息时间线。
本研究证实了什么
- 按时间先后切分仍可能泄露信息:每次月度训练边界附近,有五条训练记录的标签尚未完成。
- 每月只使用符合条件的历史记录,重新拟合标准化器和模型;评估期中较早的标签,只有在结果已可观测后才进入后续训练。
- 修改未来观测值后,有效实现的早期预测和订单完全不变,而无效对照未通过这一检验。
- 固定策略在不计手续费和滑点时收益为 +17.51%;计入成本后,66 笔已完成交易合计亏损 −1.67%。
- 预测评分、一笔亏损交易、九组开发参数和条件自助重采样路径,共同解释了为什么这一结果不足以支持投入实盘资金。
先确定时间戳,再判断这条预测当时是否可能产生
我们此前的前视偏差指南解释了常见错误。本研究实际构建并执行一套经过拟合的机器学习流水线,再将预测接入现金账户。问题很具体:六个已完成的日频价格和成交量特征,能否帮助一个简单模型选出扣除成本后盈利的五日比特币交易?
第一个有用的检查,是一个具体的验收示例。在 2024 年 1 月 1 日完整收盘时,最新可用训练特征的日期是 2023 年 12 月 26 日。其结果区间从 12 月 27 日开盘延续到 1 月 1 日开盘,因此已经可知。12 月 27 日的特征记录需要 1 月 2 日开盘价,必须排除。实际拟合使用 725 条记录,止于 12 月 26 日;对 1 月 1 日特征记录预测的概率为 0.452770,低于固定的 0.55 交易阈值。
如果某个声称复现的实现将训练数据纳入到 12 月 31 日,应先调查标签结束时间的筛选,再比较利润。如果预测概率不同,则比较 UTC 日频输入、特征顺序、标准化器统计量和软件版本。这样,读者在文章开头就有明确的排错目标,无须先相信一条漂亮的最终曲线。完整实现、研究方案、注明来源的输入、拟合记录和交易账簿,均保留在代码库研究记录中。
先冻结假设与账户规则,再计算收益
经济假设刻意保持克制:近期收益、波动率、振幅和相对交易活跃度,或许包含足以抵偿反复往返交易成本的未来五个开盘到开盘区间的方向信息。逻辑回归足够透明,可以逐项检查系数。这是值得检验的假设,不是存在优势的证据。
我们在计算本研究业绩之前记录了方案和配置。C = 1 与 0.55 阈值预先固定,没有根据最好的结果选择。后文会披露有限的开发参数网格。开发期与评估期的价格此前已用于 TensorParadigm 的其他项目,因此这是一次回顾性方法演示,而不是此前完全未接触的发现样本。
| 项目 | 固定规范 |
|---|---|
| 市场与时钟 | BTCUSDT;UTC 日频;类似现货的做多/空仓现金账户 |
| 预测 | 在完整收盘 t 时,预测 open[t+6] / open[t+1] − 1 > 0 的概率 |
| 训练 | 每月一次;此前 730 个日历日;只用结果已确定的标签;至少 252 条完整记录,且两个类别均存在 |
| 模型 | StandardScaler → LogisticRegression;C = 1,lbfgs,max_iter = 2000 |
| 入场与退出 | 空仓且 p ≥ 0.55:在 t+1 开盘买入,t+6 开盘卖出;退出成交当日不生成信号 |
| 仓位规模 | 可用现金的 90%,包含入场手续费;允许不足一枚 BTC 的数量;单一头寸;无杠杆 |
| 每侧成本 | 手续费 10 个基点;不利成交偏移 5 个基点;不额外扣除价差 |
| 开发 | 2021 年;365 根日 K 线;更早的 2020 年观测用于初始训练 |
| 验证 | 2022–23 年;730 根 K 线;另报告按年独立空仓起始的验证折 |
| 评估 | 2024–25 年;731 根 K 线;每月重新拟合流程及设置均已冻结 |
每个时期都从 10,000 USDT、空仓开始。即使下一次模型预测意见相反,预定的五日退出仍照常执行。最后允许的入场信号由已知日历决定,确保所有策略交易都能在报告期内结束。最后六个日期可以有预测,但不能发起交易,也不能将尚未确定的结果计入该期分类评分。
明确数据代表什么,也明确哪些部分尚未核实
输入包含 2020 年 2 月 20 日至 2025 年 12 月 31 日的 2,142 根完整日 K 线。我们复用 humblefool06 的 BTC-USDT 四小时数据档案,固定在修订版本 9f491eb5340dd6a24f27fde24edf098e1e785443;发布者声明采用 CC BY 4.0。每根日 K 线合并六条 UTC 观测:取第一条开盘价、最高的高价、最低的低价、最后一条收盘价,并汇总基础资产成交量。此前不完整的一天被排除。标准化 CSV 的 SHA-256 为 43655a51e6cb41c2ee087bd947f4cefb7dd4151617a29d7f75a3cda471ae5cbb。[5]
此前研究保留的 2026 年 10 月 18 日交叉核验记录,使用十进制比较,将评估期全部 731 根 K 线、即 3,655 个 OHLCV 单元格,与 Binance 日频端点逐一匹配。本研究沿用同一输入及该记录,没有为本文重新进行独立审核。数据档案未明确标明其上游交易场所。与 Binance 匹配证明的是价格一致,不能证明独立的交易场所覆盖,也不能确定上游来源。2020–23 年的训练与验证观测仍未经外部验证。Binance 以开盘时间戳标识 K 线;表中的日日期指 UTC 交易日。[6]
程序检查日期唯一且升序排列、逐日连续、OHLCV 为有限值、价格为正,以及高低价边界一致。这些检查能发现输入格式或结构问题,不能排除每一种错误观测。只研究这一项存续至今的加密资产,也不能说明历史上实际可投资资产集合的表现。报告计算使用 Python 3.13.3、pandas 2.2.3、NumPy 2.2.6 和 scikit-learn 1.6.1。
用未来价格定义结果,不能用它作为预测输入
六个输入分别是:一日、五日和二十日收盘收益;最近二十个单日收益的总体标准差;完整当日高低价差除以收盘价;以及成交量除以过去二十日均量后减一。所有窗口均包含刚结束的交易日。预热期不完整的记录直接舍弃,不使用后续值回填。当前收盘价可用于收盘后的决策,却不能用于同日更早开盘时的决策。
下列特征表达式摘自实际执行的 Python 实现。使用向后看的滚动窗口至关重要。改成居中窗口,或在完整历史上估计变换,都会改变决策时可获得的信息。Scikit-learn 的泄露指南也要求仅从训练子集学习变换。[1]
returns = close.pct_change(fill_method=None)
X = pd.DataFrame({
    "return_1": returns,
    "return_5": close.pct_change(5, fill_method=None),
    "return_20": close.pct_change(20, fill_method=None),
    "volatility_20": returns.rolling(20).std(ddof=0),
    "range_to_close": (high - low) / close,
    "relative_volume_20": volume / volume.rolling(20).mean() - 1,
})
目标使用未来开盘价,因为它描述的就是待预测结果。标签 1 表示原始退出开盘价高于原始入场开盘价;相等归为类别 0。这不表示交易扣除手续费后赚钱。下列负向 shift 只属于目标构建。最后尚未知晓的结果仍须保留为缺失值:如果仅执行比较,未知结果就会被悄悄变成错误的类别 0 观测。
target_return = open_price.shift(-6) / open_price.shift(-1) - 1
y = (target_return > 0).where(target_return.notna())
label_end = X.index + pd.Timedelta(days=6)

train_mask = (
    (X.index >= fit_date - pd.Timedelta(days=730))
    & (X.index < fit_date)
    & (label_end <= fit_date)
    & y.notna()
    & X.notna().all(axis=1)
)
训练标签延伸至未来时,仅按日期切分还不够
在 2024 年 1 月 1 日收盘时,朴素的“此前 730 天”筛选会选出 2022 年 1 月 1 日至 2023 年 12 月 31 日的特征记录。其中五条不合格:它们的结果到 2024 年 1 月 2–6 日才结束。成熟条件将其排除,剩余截至 12 月 26 日的 725 条观测。评估记录中,每次月度拟合都出现相同的五条边界排除。
图中区分了已经观测到的结果与跨过决策边界的结果。日期展示的是实际方案,不是虚构的价格路径。虽然文字中边界两侧都写作一月,但 1 月 1 日开盘价在当日收盘时已经可用,1 月 2 日开盘价尚不可用。
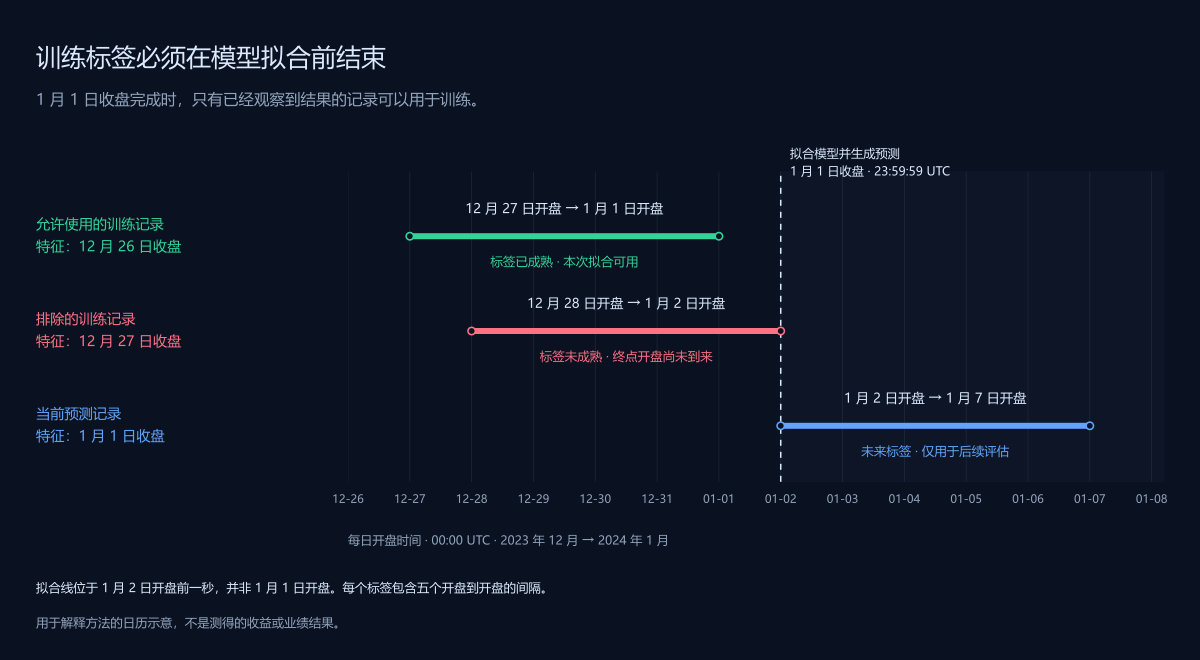
对于这一完整日历,如果 TimeSeriesSplit 的首个测试特征日期为 t,就需要五个样本的 gap,使最后一个训练特征停在 t−6。六个样本的 gap 会更保守。Scikit-learn 按样本数量而不是经过的日历时间定义 gap。可变持有期、缺失交易日和数据延迟,需要实际可用时间戳,不能照搬这个整数。记录中的实际拟合使用明确的标签结束时间掩码,并未使用 TimeSeriesSplit。[2]
这项向前推进的交易实验必须保持时间顺序。这不构成对时间序列统计中所有随机交叉验证用途的普遍判断。在本研究中,相邻五日结果相互重叠;即使一条记录日期早于测试集,它的目标也可能尚不可用。消除训练边界泄露,也不会使剩余测试结果变得统计独立。
在同一组符合条件的训练数据内拟合标准化器和分类器
每个月的首个预测日,我们新建流水线,仅用已成熟的历史记录拟合,并保留其状态直到下个月重新拟合。当天的特征记录用这些已拟合的统计量变换,不加入标准化器的拟合数据。流水线有助于维护这一边界,但无法修复来自未来的特征或错误选取的训练集。[1]
pipeline = Pipeline([
    ("scale", StandardScaler()),
    ("model", LogisticRegression(
        C=1, solver="lbfgs", max_iter=2000, random_state=6142026
    )),
])
pipeline.fit(X.loc[train_mask], y.loc[train_mask].astype(int))
assert pipeline.named_steps["model"].classes_.tolist() == [0, 1]
p_up = pipeline.predict_proba(X.loc[[signal_date]])[0, 1]
C 是正则化强度的倒数:数值越小,正则化越强。我们检查正类概率所在列,对应 classes_ = [0, 1]。记录保留特征顺序、训练记录哈希、标准化器均值和尺度、系数、截距,以及优化器迭代次数。这里使用 lbfgs 求解器;传入 random_state 并不能解释其确定性。[3]
每月重新拟合可以合法使用已经成熟的较早评估结果。例如,二月拟合可以从符合条件的一月观测中学习。这是按时间向前评估的固定更新流程,不是把一个模型冻结两年。我们从未使用后续评估结果修改 C、阈值、特征或重新拟合日程。调整这些选择,需要新的评估方案。
重建第一条被接受的预测,而不是直接相信 predict_proba
评估期第一条被接受的信号出现在 2024 年 1 月 12 日收盘。它仍使用 1 月 1 日拟合:725 条训练记录,日期从 2022 年 1 月 1 日至 2023 年 12 月 26 日,最新训练结果在 1 月 1 日开盘结束。表中给出实际特征向量、用训练集统计量标准化后的值,以及拟合系数。显示值经过四舍五入;审核计算使用完整精度。
| 特征 | 原始值 | 标准化 z | 系数 |
|---|---|---|---|
| return_1 | −0.076748 | −2.672794 | −0.103549 |
| return_5 | −0.026094 | −0.417899 | −0.111867 |
| return_20 | −0.021039 | −0.200837 | +0.039253 |
| volatility_20 | 0.030521 | 0.420563 | +0.026111 |
| range_to_close | 0.117233 | 2.754973 | −0.019805 |
| relative_volume_20 | 0.778955 | 1.552860 | +0.037502 |
对每个特征,z = (x − 训练均值) / 训练尺度。截距 0.014133035 加上各项 z 与系数乘积之和,得到 logit 0.344416426。代入 1 / (1 + exp(−logit)),得到 0.585262925。它超过 0.55,因此空仓账户提交 1 月 13 日开盘买单。这是模型给出的价格毛变动为正的概率,不是经过校准的交易净盈利概率。
评估期首日概率为 0.452769888,正确地没有触发交易。这两个审核点有助于区分特征或拟合差异,与订单处理差异。即使预测正确,成交时点、现金仓位规模或退出时钟有误,仍会把它变成错误的回测。
将预测、订单和现金账户分开处理
符合条件的收盘信号,安排在下一次开盘入场,再在五个开盘到开盘区间后退出。模拟在实际成交时分配现金:数量 = 0.90 × 现金 / (买入成交价 × 1.001)。这描述的是成交时由执行端按现金分配头寸,而不是昨天利用明天未知开盘价算出数量。买入成交价为原始开盘价 × 1.0005;卖出成交价为原始开盘价 × 0.9995。每侧手续费都是含滑点成交名义金额的 0.001。
if flat and not exited_today and p_up >= 0.55:
    entry_date = signal_date + pd.Timedelta(days=1)
    exit_date = signal_date + pd.Timedelta(days=6)
    if exit_date <= evaluation_end:  # known calendar, not future prices
        pending_buy = (entry_date, exit_date)

# At the entry open:
fill = open_price * 1.0005
quantity = 0.90 * cash / (fill * 1.001)
每个日收盘时,权益等于现金加上 BTC 数量乘以原始收盘价。回撤以这一日收盘账户的运行峰值计算,包含初始余额。滑点已嵌入价格,不再重复扣除。策略头寸全部在报告期内结束;买入持有则在最终收盘仍持有 BTC,已计入入场手续费,不虚构退出手续费。
加密市场的日收盘与下一次开盘紧邻。恰在下一次开盘成交是一项理想化假设:本研究没有证明模型计算、交易所或网络延迟能满足这一要求。五个基点是敏感性假设,不是实际订单簿测量。我们未计入杠杆、做空、止损、资金费、现金利息、税收、固定运营支出及 USDT 兑换;允许小数数量,忽略了交易所数量过滤规则。这些选择界定了模拟范围。
固定模型扣除成本后亏损,也落后于简单持有基准
毛收益来自手续费和滑点均设为零的另一次账户运行。净收益采用每侧固定十个加五个基点的假设。开发、验证和评估账户各自从 10,000 USDT 开始。表中报告的是实测结果,不是拟合出来的期望。
| 时期 | 机器学习毛收益 | 机器学习净收益 | 机器学习最大回撤 | 已平仓交易 | 买入持有净收益 |
|---|---|---|---|---|---|
| 开发 2021 | +26.88% | +10.56% | 41.81% | 51 | +53.60% |
| 验证 2022–23 | −40.06% | −46.76% | 54.13% | 44 | −7.78% |
| 评估 2024–25 | +17.51% | −1.67% | 27.82% | 66 | +96.28% |
评估期结束时,机器学习账户为 9,832.51 USDT,无未平仓 BTC;已完成交易损益为 −167.49 USDT。尽管平均投资敞口仅为 40.63%,最大日收盘回撤 27.82% 也只比买入持有的 30.86% 略低。731 个日收盘中,它有 330 天持有 BTC。敞口更低,不自动意味着风险调整后更有吸引力。
两个决策规则基准采用相同的五日持有、冷却、仓位规模和成本规则。当已完成的二十日收益为正时买入,在 71 笔交易中收益为 −11.63%,回撤为 33.99%。当每月已成熟训练样本中正标签比例达到 0.55 时交易,在 36 笔交易中收益为 −26.56%,回撤为 37.85%。机器学习规则在这里胜过这两个规则,但仍然亏损,且大幅落后于持有基准。这不足以证明其特征带来了持久的经济优势。
图中账户使用实际计算的每日权益。买入持有在每期首次开盘投入 90%,使用相同入场成本,并保留 10% 现金。它高得多的市场敞口是比较的一部分,而不是对机器学习因果贡献的控制估计。更广泛的解读见我们的机器学习与规则交易研究。
预测准确率与交易盈利是不同的测量
我们为评估期 725 条结果已完整观测的预测评分,包括账户已经持有 BTC 时生成的预测。其余六条结果延伸至报告期之外,予以排除。正标签共 390 条,占 53.79%。频率基准不使用六个特征,每个月只预测当月拟合时已成熟训练标签的正类比例。
准确率使用 0.50 分类阈值,订单使用 0.55。Brier 分数衡量概率的平方误差,对数损失以对数方式惩罚概率误差,ROC AUC 衡量排序能力。这些数值不包含仓位规模或手续费。Brier 分数更低本身也不能证明校准更好,因为它反映的不只有校准。我们的概率没有单独校准。[4]
| 评估预测 | 准确率,阈值 0.50 | Brier ↓ | 对数损失 ↓ | ROC AUC |
|---|---|---|---|---|
| 六特征逻辑回归 | 50.76% | 0.251416 | 0.695919 | 0.502044 |
| 已成熟训练标签频率基准 | 53.79% | 0.249933 | 0.693033 | 0.476881 |
机器学习模型的 Brier 分数和对数损失均未优于频率基准。其 AUC 为 0.5020,接近 0.5,但对这些相互重叠的结果,我们不作基于独立观测的显著性判断。725 条预测也不等于 725 笔独立交易:账户实际完成 66 笔交易。这些微小评分差异,未提供足以反驳经济结果的有力预测证据。
沿两次成交与现金余额追踪第一笔亏损交易
1 月 12 日的 0.585262925 预测触发第一笔交易。1 月 13 日原始入场开盘价为 42,782.74 USDT。加入五个基点的不利执行偏移后,买入成交价为 42,804.131370。数量为 0.210050027959 BTC。入场名义金额为 8,991.008991 USDT,手续费为 8.991009,恰好留下 1,000 USDT 现金。
1 月 18 日按计划必须退出,原始开盘价为 42,776.09,卖出成交价为 42,754.701955。退出手续费为 8.980626 USDT。两次含滑点成交价之间的价格损益为 −10.382650,再扣除两侧手续费,得到 −28.354285 USDT。最终现金为 9,971.645715。这与初始 10,000 及最终空仓相符;模型概率没有推翻预定退出。
评估期全部 66 笔交易中,32 笔扣除成本后盈利、34 笔亏损,胜率为 48.48%。平均盈利交易为 +332.83 USDT,平均亏损交易为 −318.18,盈亏比约为 1.05。平均每笔损益为 −2.54 USDT,利润因子为 0.9845。胜率或价格毛方向预测,都不能单独解释现金结果;手续费、成交价、变化的资金规模和盈亏幅度同样起作用。
让泄露信息的模型无法通过检验,即使它的收益看起来很好
我们修改了 2024 年 6 月 15 日之后的每条观测:OHLC 价格翻倍,成交量变为三倍,更早的值全部保持不变。重新构建有效模型后,此前的特征、符合条件的训练矩阵、标准化器与模型状态、预测、决策和成交均未变化。此前预测概率的最大差异严格为零。这是针对本实现实际执行的一项不变性检验,不是已消除所有可能偏差的证明。
changed = bars.copy()
future = changed.index > cutoff
changed.loc[future, ["open", "high", "low", "close"]] *= 2
changed.loc[future, "volume"] *= 3
# Valid: past features, fit states, predictions and orders are identical.
# INVALID control: X also contains target_return, so this check fails.
负面对照故意把实际未来开盘到开盘收益加入为第七个输入。它保留相同月度流水线和账户规则,却违反预测时点的信息可用性要求。其表面净收益为 +867.06%,分类准确率为 97.66%,AUC 为 0.998676。这些是无效回测(INVALID)的测量结果,既不是候选策略,也未用于选择设置。
同一次未来数据修改,使无效模型此前的概率最多变化 0.998626629。对照说明,干净的标准化器、按时间拟合和看似合理的订单核算,都无法挽救一个当时不可用的输入。相比之下,边界处五个未成熟标签是更隐蔽的错误:无须出现醒目的业绩变化,仅凭日历就能证明它们无效。
研究测试还覆盖向后看特征的时序、期末缺失标签、准确的标签成熟边界、仅在训练集上标准化、月度拟合复用、分类评分期边界、不重叠订单、退出当日冷却、含手续费的仓位规模、现金与损益核对,以及确定性的区块重采样。因果性检验应该能让一个已知有错的版本失败;仅仅看到代码能够运行,证据很弱。
披露开发网格,并保留不理想的向前验证结果
我们只评估了九种开发组合:C ∈ {0.1, 1, 10},入场阈值 ∈ {0.50, 0.55, 0.60}。表中列出 2021 年净收益。所有变体均保留,包括随阈值改变而失去吸引力的那些。预先声明的 C = 1、阈值 = 0.55 仍是本文策略,即使其他开发设置看起来更好。
| C | 阈值 0.50 | 阈值 0.55 | 阈值 0.60 |
|---|---|---|---|
| 0.1 | +7.81% | +10.56% | +25.24% |
| 1 | +7.81% | +10.56% | +55.01% |
| 10 | +7.81% | +10.56% | +55.01% |
阈值为 0.50 和 0.55 时,三个 C 值产生相同的实际交易路径;这不代表其预测概率相同。阈值为 0.60 时,C = 0.1 的路径不同。阈值改变会影响交易资格与后续冷却机会,因此细微预测差异也可能改变复利收益。这个网格没有找出跨市场时期稳定盈利的区域。
验证采用固定流程,每月滚动拟合。独立年度账户在 2022 年的 37 笔交易中亏损 −44.04%,在 2023 年的七笔交易中亏损 −4.87%;最大回撤分别为 54.13% 和 8.60%。这些验证折各自从空仓开始,并有各自的期末日历限制,因此将年度收益复合起来,不会完全等于连续运行的 2022–23 账户。连续评估账户中,2024 年收益为 −1.14%,2025 年为 −0.54%。
挑选历史上最好的变体,与评估一条固定规则,是不同的研究流程。Bailey 及其合作者形式化讨论了从多个回测中选择如何导致过拟合。我们披露这个小型网格与不利的验证折,没有声称仅用九种设置就估计了正式的回测过拟合概率。报告后若修改配置,这些时期就成为开发证据。[7]
换手消耗毛收益,少数交易显著影响结果
评估账户共有 132 次成交。买卖名义金额总和为初始权益的 122.29 倍;这一单边换手定义将两侧均计入,不代表整个账户完整往返 122 次。手续费合计 1,222.92 USDT。相对原始开盘价、已嵌入成交价的执行损耗合计 611.46 USDT。成本变化还会改变后续仓位数量,因此直接从另行运行的毛收益账户中扣除这些账簿合计,并不能精确重建净结果。
敏感性表只改变不利滑点,每侧十个基点手续费和模型决策均不变。即使滑点为零,收益也只有 +4.34%;十个基点滑点时则为 −7.34%。因此,本研究未能证明存在充足的执行余量。不计手续费和滑点的 +17.51% 有助于理解核算,却不是可实现净收益的预测。
| 每侧手续费 | 每侧滑点 | 评估期净收益 | 最大回撤 |
|---|---|---|---|
| 10 个基点 | 0 个基点 | +4.34% | 27.37% |
| 10 个基点 | 5 个基点 | −1.67% | 27.82% |
| 10 个基点 | 10 个基点 | −7.34% | 28.27% |
| 10 个基点 | 20 个基点 | −17.72% | 30.67% |
净盈利最大的三笔交易合计贡献 +2,764.12 USDT。其余已完成交易合计为 −2,931.61。这是利用已发生账簿进行的描述性集中度计算,不是删除那些交易、再让后续现金随之变化的重新运行。提出改进时,应说明如何利用事先可得的信息保留盈利或减少换手;删除历史亏损交易只会制造另一个有偏结果。
重采样账户路径,但不把它当成新证据
我们抽取连续二十个净日账户收益的循环区块,包含空仓日,直到每条路径达到 731 天,共生成 5,000 条条件路径。种子 6142026 固定计算。使用 Politis 与 White 所述的循环重采样构造,在样本末端回绕并保留连续区块,可以保留部分局部依赖。我们的区块长度固定为二十天,没有使用他们的自动选择方法。这一选择不能保证捕捉了所有相关依赖,也不能保证收益过程平稳。[8]
期末收益的第五百分位、中位数和第九十五百分位分别为 −42.11%、−1.03% 和 +61.61%。最大回撤对应为 16.79%、30.26% 和 51.19%。重采样路径中有 51.44% 的最终权益低于初始权益。这一比例以历史样本和重采样规则为条件,不是该策略在现实世界中亏损的概率估计。
这项自助法重新排列的是已经实现的账户收益序列。它不重新生成价格、不重新拟合模型,也不重算订单;抽出的序列不一定是可行的交易历史。它探索的是以已发生事实为条件的路径敏感性。增加重采样路径可以降低模拟噪声,但不会增加市场观测、独立交易或预测优势的证据。
给 AI 协作者可实际检查的验收条件
ChatGPT 或 Claude 可以帮助把交易想法转成精确定义,并质疑歧义。Codex 或 Claude Code 可以操作代码库文件、执行计算并检查失败。官方产品文档支持这些开发用途,但这些能力都不能证明交易优势。本项目使用 Codex 辅助和本地 Python 计算。我们没有进行受控的 ChatGPT 与 Claude 对比,没有使用大语言模型产生市场预测,也没有获得独立专家审核。[9] [10]
下列提示词让四种不同工作可以审核。每次请求都应提供冻结的规范与相关代码。市场数据提供观测,可执行程序计算结果,研究者判断假设与证据是否足以支持新测试。自信的叙述不能代替核对一致的账簿。更广泛的开发流程见构建与测试交易算法。
明确一项 UTC 日频 BTCUSDT 做多/空仓机器学习实验。在完整收盘 t 时,预测 open[t+6]/open[t+1]-1 的符号。定义每个特征的可用时间、目标成熟时间、月度训练窗口、入场/退出日历、现金仓位规模与成本。区分重新拟合与超参数选择。列出歧义,并给出 2024-01-01 收盘时最新符合条件的训练特征日期。不要计算业绩,也不要根据收益选择设置。实现所附冻结规范,将特征/标签、月度拟合和现金账户分成独立函数。只在标签已成熟的训练切片内拟合 StandardScaler。保留期末缺失标签。记录符合条件的日期、特征顺序、标准化器状态、系数、概率、决策和成交。不要重新调优 C=1 或 threshold=0.55。增加一项测试:修改未来 OHLCV 后,此前所有有效预测和订单都应不变;并展示故意加入 target_return 特征的版本无法通过该测试。审核 2024-01-12 信号,不修改策略。用 2024-01-01 的拟合,重建标准化特征、logit 和概率。按照十个基点手续费与五个基点不利成交,追踪 1 月 13 日入场及 1 月 18 日退出。展示数量、现金、两次手续费与净损益。将最终权益核对为初始现金加已平仓和未平仓按市值计量损益。找出第一条存在差异的记录,不要只解释最终收益。根据记录输出撰写研究报告。包含全部开发变体、时间顺序时期、毛/净收益、基准、预测评分、回撤、敞口、换手、交易盈亏不对称、成本与集中度。解释重叠标签及条件区块自助法的限制。未来特征对照无论出现在哪里,都标记为无效(INVALID)。区分实际执行的计算、示意代码与未执行的组件。披露此前对价格的熟悉程度及数据验证限制。不要为获得盈利标题而优化。对于这套滚动 scikit-learn 流水线,我们没有提供或执行对应的 Pine 实现。只复制某一个拟合月份的系数,会把它冻结成不同的策略;忠实比较必须复现训练窗口、标准化、标签成熟、重新拟合和执行语义。这是本研究的范围限制,不是说 Pine 无法表达机器学习计算。我们的 Python–Pine 回测研究解释了为什么仅匹配信号公式还不够。
有依据的下一步是记录前瞻测试,而不是部署
实现通过了我们检验的因果性质,但固定策略扣除成本后亏损,主要概率评分未见改善,验证期还发生严重回撤。这些发现不足以支持投入实盘资金。本文有用的结果,是一种区分有效历史测量与信息泄露所制造漂亮盈利的方法。
如果继续研究,应在新的前瞻模拟交易区间开始之前,就将它记录下来。冻结特征集、成熟规则、重新拟合日程、成本及报告标准。为每次完整输入、拟合状态、信号与可行的下一次执行标记时间戳,测量实际延迟和报价价差。与训练标签频率预测及简单持有账户比较。保留每项提出的变体,后续数据只有在结果成熟后才归入评估。
由于成本明显改变本研究结果,降低换手的设计是合理的新假设,但它必须通过自己的后续测试。如果重复使用 2024–25 年来选择不同阈值或持有期,这些日期就成为开发数据。单一市场、更早数据未获外部验证、结果之间存在依赖、理想化成交以及没有实盘执行,都限制了本研究能证明的内容。通过前视检查,是解释回测的必要条件;盈利仍需要单独的证据。
机器学习交易回测的审核清单
- 选取一条实际预测,明确观测、拟合、决策和成交各自的准确时间。
- 证明每个训练目标在拟合前都已确定;不能只看特征日期的先后顺序。
- 只在符合条件的训练记录上拟合变换,保留特征顺序,并保存每个月的模型状态。
- 让期末尚未确定的标签保持缺失,并区分预测评分与实际执行的交易。
- 修改未来数据后,早期输出应保持不变;同时确认一个已知泄露信息的对照无法通过检验。
- 核对两次成交的成本和现金,包括未平仓头寸的按市值计价,以及已经包含在成交价内的滑点。
- 报告全部尝试过的设置、不利时期、合适的基准,以及对现实成本的敏感性。
- 在看到用于评判下一项前瞻研究的证据之前,先冻结它的完整流程。
机器学习回测中的实际问题
按时间切分训练集与测试集,就能防止前视偏差吗?
这样能阻止部分未来信息混入过去,但还不够。位于边界之前的训练记录,其结果可能在边界之后才结束。我们的五日目标要求每次拟合都排除五条尚未成熟的记录。预处理、特征可用时间和订单时序也需要分别检查。
每个特征都应该向后移动一天吗?
不必。需要移动多少,取决于实际时序。今天已经完成的收盘价和全天成交量,可以支持今天收盘后生成、稍后成交的信号;却不能支持今天更早的开盘成交。盲目移动全部输入,可能改变原本的策略,同时仍未消除其他泄露。
评估期的观测值可以进入后续月份的训练集吗?
可以,前提是更新流程已事先固定,并且该观测的目标在拟合时已经成熟。这模拟了运行中的模型从新近可用的历史中学习。查看评估结果后再修改超参数,是另一项选择决策,需要新的评估证据。
预测概率高于 0.55,就意味着这笔交易的预期利润为正吗?
不意味着。我们的标签描述的是未经成本调整的五日开盘到开盘收益是否为正。净期望收益还取决于盈亏幅度、成本、资金和执行。模型概率未另行校准,而有效策略在计入所设成本后亏损。
交易标签在 TimeSeriesSplit 中应设置多大的 gap?
应根据标签实际可用的时间推导。对于我们完整的日频数据和收盘 t 时的决策,最晚训练特征为 t−6,等价于在首个测试特征 t 之前留出五条记录。其他目标、交易日历和数据发布延迟,可能需要不同的 gap,或直接按时间戳筛选。
ChatGPT 或 Claude 能验证机器学习交易机器人是否盈利吗?
它们可以帮助明确实验、检查代码并解释已记录的输出。盈利判断必须来自对时序正确的观测进行可执行计算,之后还需要现实条件下的进一步证据。本研究使用 Codex 辅助,得到不利的固定策略结果;没有比较不同 AI 的投资能力,也没有进行实盘交易。
来源与研究记录
收益、模型输出和账户示例均为 TensorParadigm 实际执行的计算。代码库研究记录保留了计算业绩前制定的方案、配置、注明来源的标准化数据、可运行的 Python 实现、测试、全部模型拟合记录及完整账簿。以下一手来源支持文中的方法、数据和工具说明,并不为策略背书。Scikit-learn 引用采用 1.6 文档,对应实际使用的 1.6.1 环境。
- Scikit-learn 1.6:常见陷阱、仅在训练集上拟合的变换与数据泄露
- Scikit-learn 1.6:TimeSeriesSplit 及按样本计数的 gap
- Scikit-learn 1.6:LogisticRegression 配置与概率对应的类别顺序
- Scikit-learn 1.6:分类与概率评分指标
- humblefool06:BTC-USDT 四小时数据档案、固定的发布者修订版本与许可声明
- Binance 现货 API:K 线时间戳与市场数据端点
- Bailey 等:《回测过拟合的概率》
- Politis 与 White:《相关数据自助法的自动区块长度选择》,含循环重采样方法
- OpenAI:代码生成与 Codex 开发指南
- Anthropic:Claude Code 概览
本研究用于教学,是采用可变成本假设和理想化成交的回顾性研究。未进行实盘交易、独立专家审核或不同 AI 投资能力的对比实验。历史结果与重采样结果都不能证明未来盈利。